
Stable Diffusion 1.5 AIモデル
Stable Diffusion 1.5は2022年のモデルで、オープンソース画像ムーブメントの始まりです。512ピクセルの潜在拡散モデルでほぼすべてのGPUで動作し、LoRAを数分でトレーニングでき、テキストインバージョン埋め込みの最大ライブラリを持ちます。Realistic Vision、DreamShaper、Deliberate、ReV Animated、Anythingなどが世代を定義したチェックポイントです。新しいファミリーはプロンプト追従や解像度で上回りますが、SD 1.5は学習の最速手段であり、弱いハードウェアに最適で、多くのクラシックスタイルの唯一のホームです。
人気の Stable Diffusion 1.5 モデル

9540°
sdv15
9498°
ReV Animated
9486°
Counterfeit V3.0
9440°
DreamShaper
9426°
Beautiful Realistic Asians
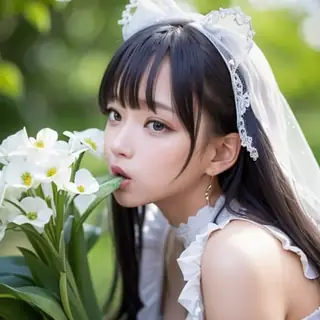
9337°
chilloutmix
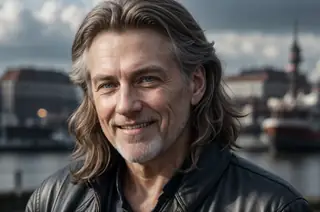
9307°
ICBINP "I Can't Believe It's Not Photogr...
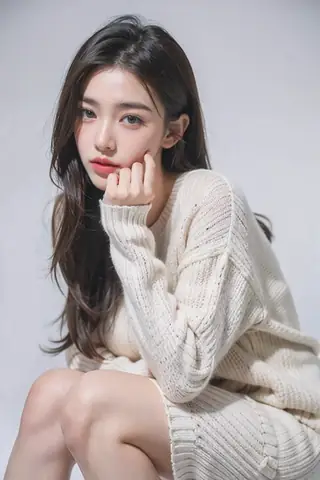
9299°
majicMIX realistic 麦橘写实
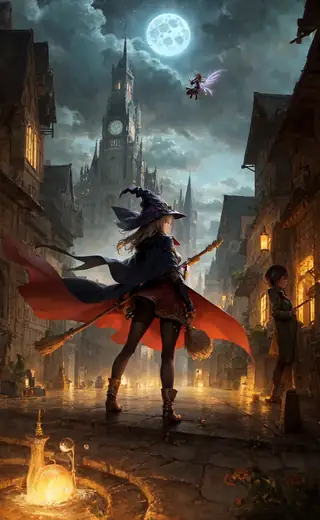
9255°
AbyssOrangeMix3 (AOM3)
9254°
CyberRealistic Final

9247°
Add More Details Detail Enhancer / Tweak...

9242°
waifu
Stable Diffusion 1.5 ガイド
モデル
Stable Diffusion 1.5: 正しくプロンプトを使うクラシックモデル
Stable Diffusion 1.5はまだ覚えておく価値があります。適切な解像度、CFG、サンプラーの使い方、膨大なLoRAや埋め込みのライブラリの活用法、512ピクセルモデルに合ったクリエイティブなプロンプトのアイデアを紹介します。
モデル
Waifu Diffusion:クラシックなアニメモデルのためのDanbooruタグプロンプト
Waifu Diffusionは、Danbooruタグでプロンプトを作る方法を教えたアニメベースモデルです。このガイドではタグの順番、品質タグ、ネガティブタグ、適切な解像度、きれいなアニメイラストのアイデアを説明します。

エラーと対処法
ComfyUIのエラーとその直し方:赤いノード、モデルがない、CUDAのメモリ不足
ComfyUIでよく出るエラーメッセージ、それぞれの意味と効果的な直し方:カスタムノードがない(赤いボックス)、"Prompt outputs failed validation"、CUDAのメモリ不足、間違ったモデルタイプの読み込み、mat1とmat2の形状エラー、ヘッダーのデシリアライズエラー、torchとxformersの不一致。

モデル
LoRAとは何か、ComfyUI、Forge、Automatic1111、クラウドでの使い方
結果を求める人向けにLoRAを解説:LoRAファイルが何を変えるか、なぜベースモデルのファミリーと合わなければいけないか、トリガーワード、重み、複数LoRAの重ね掛け、各UIのフォルダと構文、ダウンロード前にクラウドで試す方法。

エラーと対処法
CUDAのメモリ不足:各AIモデルが必要とするVRAM量と収める方法
SD 1.5、SDXL、Flux、FLUX.2、Qwen-Image、Z-Image、Wan 2.2、HunyuanVideoのVRAM表と、モデルを収めるための技術:fp8とGGUF量子化、CPUオフロード、タイル状VAE、解像度とフレーム制限、そして諦めてホスティングで動かすタイミング。

モデル
Flux vs SDXL vs SD 1.5 vs Qwen vs Z-Image: 2026年に使うべきモデルファミリーはどれ?
オープンな画像モデルファミリーの実用的な比較:プロンプトの追従性、リアリズム、アニメやイラスト、テキスト表現、速度、VRAM、LoRAエコシステムとライセンス、それぞれの作業やハードウェアに合ったおすすめを紹介。
他のモデルファミリー
Text / LLM モデル
434
Anima モデル
528
Chroma モデル
19
Fibo モデル
2
Flux モデル
1,496
Flux 2 / Klein モデル
1,239
Flux 3 モデル
3
Moss モデル
3
Iris モデル
1
MiniMax H3 モデル
364
Hunyuan モデル
204
Ideogram モデル
20
Krea2 モデル
717
Qwen モデル
20
Qwen2 モデル
47
Ltx2 モデル
153
Stable Diffusion XL 1.0 モデル
17,446
Zimage モデル
815
Wan モデル
1,067
ACE-Step モデル
2
AuK モデル
1
Boogu モデル
2
Chatterbox TTS モデル
1
Cosmos モデル
1
Ernie Image モデル
2
FireRed モデル
1
HeartMuLa モデル
1
HiDream モデル
3
Higgs Audio モデル
1
JoyAI Echo モデル
1
Lumina モデル
2
MiniMax Music モデル
1
MisoTTS モデル
1
Microsoft Lens モデル
1
PixelDiT モデル
1
Stable Diffusion 3.5 モデル
12
SFX Bank モデル
1
Upscalers モデル
14
YuE モデル
2