Ltx2 KI-Modelle
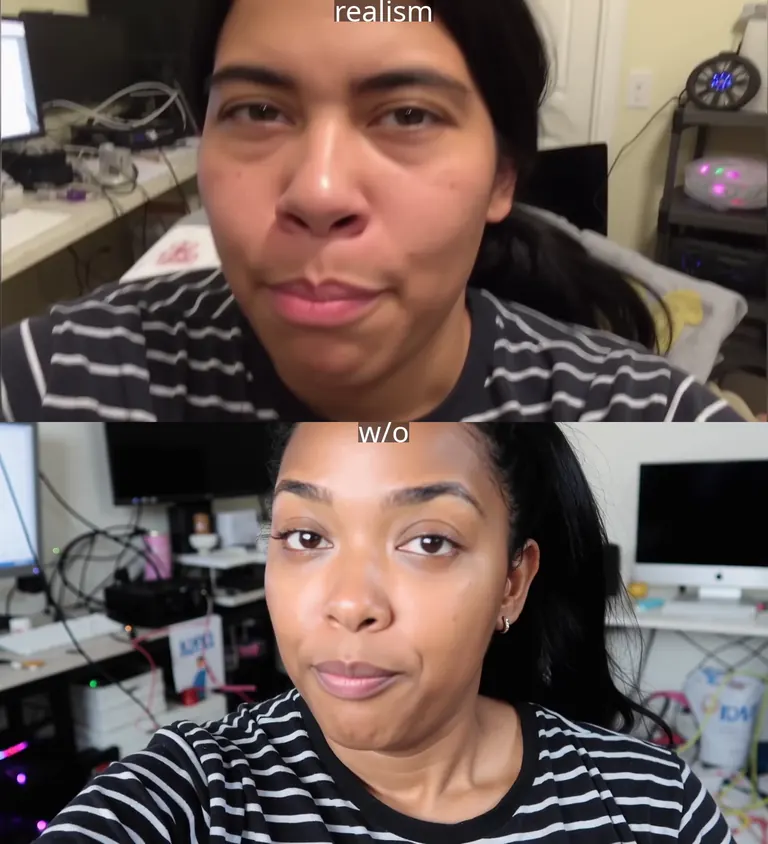
LTX-2 is Lightricks' open video model with synchronised audio, fast enough to generate 4K clips in near real time on a single GPU and released with full weights and training code. It follows long cinematic prompts, keeps characters stable across the shot and produces sound that matches the picture. The LoRAs here add styles, camera moves and characters; the LTX-2.5 prompting field guide on this site covers the prompt format in detail.
Heißeste Ltx2-Modelle
Ltx2-Anleitungen

Cloud-Dienste
Pauschalpreis vs. Tokens: Warum unbegrenzte Pläne wie Graydient.ai 2026 den besten Wert für KI-Schöpfer bieten
Ein kostenbasierter Vergleich, Stand 8. Oktober 2026, von Pauschalpreisen für unbegrenzte Pläne wie Graydient.ai gegenüber Token- und Kreditpreisen von Midjourney, Leonardo, fal.ai, Replicate, Runway und Kling: Was 1.000 Bilder und 1.000 Videos pro Monat wirklich kosten und warum eine feste Gebühr für unbegrenzte Bilder, Videos, Audio, Grok LLM-Chat und Web-Apps für Schöpfer, die viel ausprobieren, am besten ist.
Von Captain
2026-10-08
Cloud-Dienste
PirateDiffusion: Führe jedes Modell über Telegram aus, keine GPU nötig
Die wichtigsten Befehle im PirateDiffusion Telegram-Bot: /render mit Modell-Triggerwörtern, (( )) und [[ ]] Gewichtung, #recipes, /adetailer, /highdef und /facelift Upscaling, /remix, /inpaint, ComfyUI Workflows mit /wf /run:, und die neuen // Skills, die das Modell für dich auswählen.
Von Captain
2026-10-03
ComfyUI
LTX-2 Text-zu-Video ComfyUI Workflow: Bild und Ton aus einem Prompt
Die ComfyUI-Teamvorlage für LTX-2 Text-zu-Video: der 19B fp8 Checkpoint, der Gemma 3 Textencoder, ein zweipassiges Rendern mit dem 2x Latent-Upscaler und dem distillierten LoRA sowie synchronisierter Ton. Fünf Dateien, die 64-Pixel- und 8n+1-Regeln und wie man Dialoge promptet. Workflow-JSON hier gehostet.
Von Captain
2026-10-09
ComfyUI
LTX-2 Bild-zu-Video ComfyUI Workflow: Ein Standbild mit synchronisiertem Ton animieren
Die LTX-2 Bild-zu-Video Vorlage des ComfyUI-Teams: Bild in LTXVImgToVideoInplace laden, den 19B fp8 Checkpoint und Gemma 3 Encoder, den zweiphasigen Upscale mit dem distillierten LoRA, Audio mit dem Clip generiert. Fünf Dateien, Größenregeln und Prompting für Bewegung plus Ton. Workflow JSON hier gehostet.
Von Captain
2026-10-09
Fehler & Lösungen
VRAM-Anforderungen für alle beliebten KI-Bild- und Videomodelle (2026): Volle Präzision, FP8 und GGUF
Wie viel VRAM du für SD 1.5, SDXL, SD 3.5, Z-Image Turbo, FLUX.1, FLUX.2 Klein und Dev, Qwen-Image, Wan 2.2, HunyuanVideo 1.5 und LTX-2 brauchst – in voller Präzision, FP8 und 4-Bit GGUF, mit der passenden Karte und Lizenz für jedes Modell, was jede GPU-Größe von 8 bis 48 GB schafft und in welcher Reihenfolge du Anpassungen machst, wenn ein Modell nicht passt.
Von P.I. Panda
2026-10-06

Videomodelle
Wie viel VRAM brauchst du für KI-Video? Wan 2.2, HunyuanVideo 1.5 und LTX-2 nach GPU-Größe (2026)
Benötigter VRAM für das lokale Ausführen von Wan 2.2, HunyuanVideo 1.5 und LTX-2, nach GPU-Größe, Auflösung und Clip-Länge: was 8, 12-16, 24, 32 und 48+ GB Karten schaffen, warum Video hundertmal mehr kostet als ein Bild, die Tricks zum Auslagern, die 14B-Modelle auf 24 GB passen lassen, realistische Generierungszeiten und wann Mieten besser ist als Kaufen.
Von P.I. Panda
2026-10-06
AD
Keine Installation nötig – KI-Modelle in der Cloud ausführen
Keine GPU, keine Downloads, kein Python. Diese Dienste führen dieselben Open-Source-Modelle auf ihren eigenen Servern aus, sodass du in einer Minute im Browser, auf Discord oder Telegram loslegen kannst.


Weitere Modellfamilien
Text / LLM-Modelle
415
Anima-Modelle
367
Chroma-Modelle
12
Flux-Modelle
950
Flux 2 / Klein-Modelle
708
MiniMax H3-Modelle
150
Hunyuan-Modelle
105
Ideogram-Modelle
7
Krea2-Modelle
378
Qwen-Modelle
14
Qwen2-Modelle
26
Stable Diffusion 1.5-Modelle
4,871
Stable Diffusion XL 1.0-Modelle
8,688
Zimage-Modelle
349
Wan-Modelle
470
ACE-Step-Modelle
2
AuK-Modelle
1
Boogu-Modelle
2
Chatterbox TTS-Modelle
1
Cosmos-Modelle
1
Ernie Image-Modelle
2
FireRed-Modelle
1
HeartMuLa-Modelle
1
HiDream-Modelle
3
Higgs Audio-Modelle
1
JoyAI Echo-Modelle
1
Lumina-Modelle
2
MiniMax Music-Modelle
1
MisoTTS-Modelle
1
Microsoft Lens-Modelle
1
PixelDiT-Modelle
1
Stable Diffusion 3.5-Modelle
11
Upscalers-Modelle
12
YuE-Modelle
2

Model
Trends
.ai
© ModelTrends.ai
|
© 2026
|
Alle Rechte vorbehalten