Las apps que soportan etiquetas de ModelTrends te permiten ejecutar/instalar modelos copiando este código en tu prompt sin configuración. Busca nuestro ícono en apps que lo soporten, como Prism (abajo).
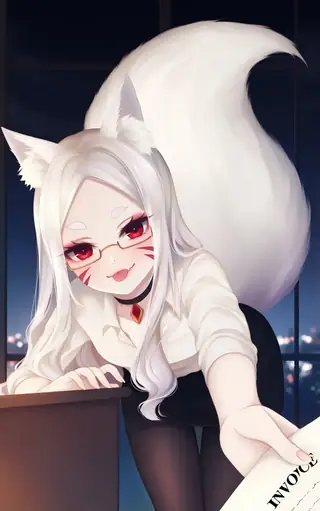
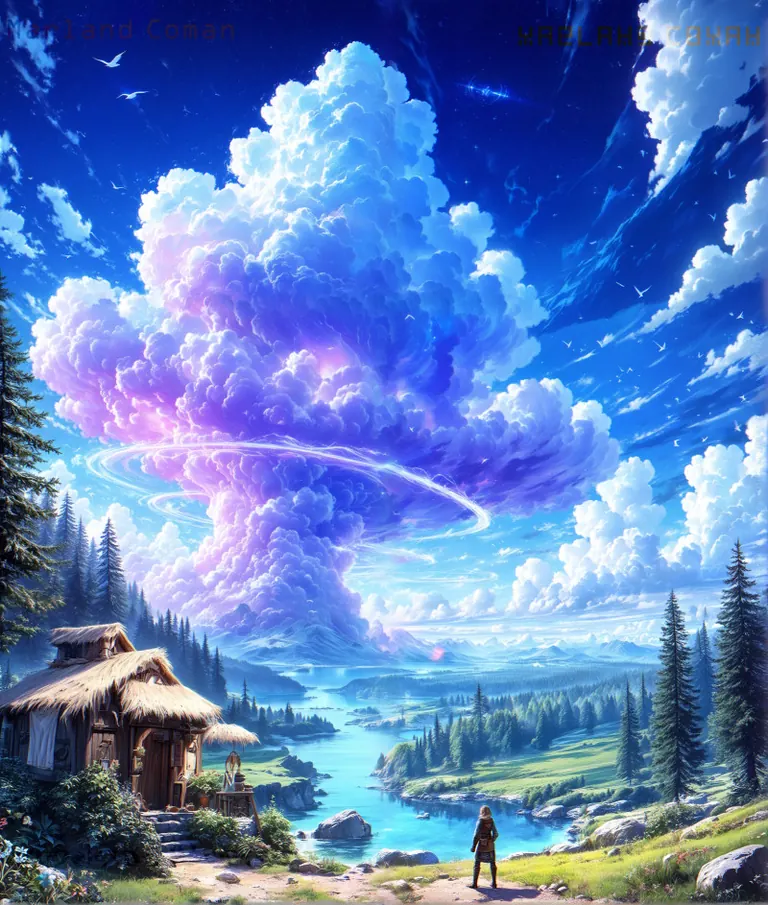
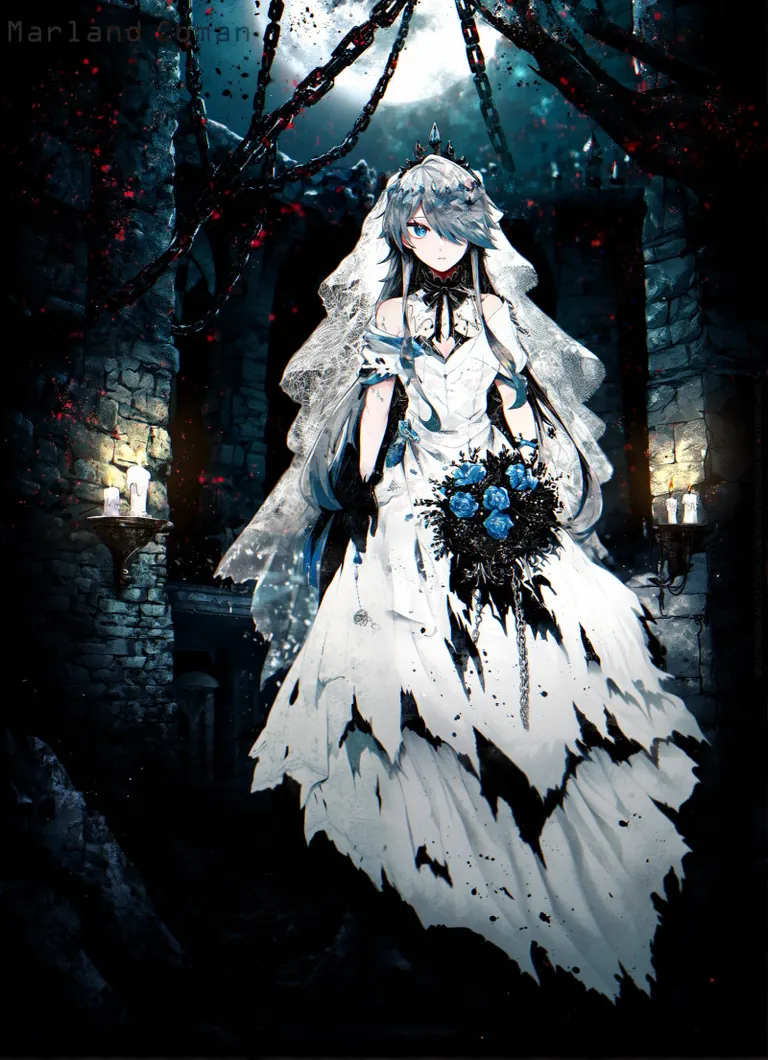
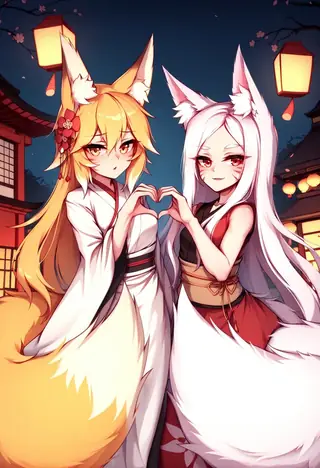
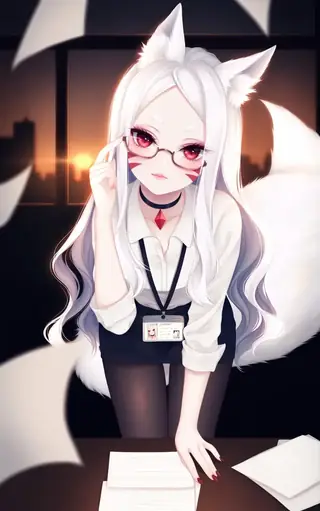
by Minthybasis - Advanced illustrious model, somewhere between an anime and furry style. Hard to work with but gives incredible range of lightning and poses for those that are up for the challenge. This is a large scale fine-tune with 4.5 million pictures using danbooru tags, so e621 isn't understood. Use guidance 5-7 at 20-30 steps. To get a sharp photo, render three steps: upscale by 1.5x at strength 0.6, then again at 0.3x at strength 0.55. General styles: 2.5d, anime screencap, bold line, sketch, cgi, digital painting, flat colors, smooth shading, minimalistic, ink style, oil style,…by Minthybasis - Advanced illustrious model, somewhere between an anime and furry style. Hard to work with but gives incredible range of lightning and poses for those that are up for the challenge. This is a large scale fine-tune with 4.5 million pictures using danbooru tags, so e621 isn't understood. Use guidance 5-7 at 20-30 steps. To get a sharp photo, render three steps: upscale by 1.5x at strength 0.6, then again at 0.3x at strength 0.55. General styles: 2.5d, anime screencap, bold line, sketch, cgi, digital painting, flat colors, smooth shading, minimalistic, ink style, oil style, pastel style Booru tags styles: 1950s (style), 1960s (style), 1970s (style), 1980s (style), 1990s (style), 1990s (style), animification, art nouveau, pinup (style), toon (style), western comics (style), nihonga, shikishi, minimalism, fine art parody and everything from this group. Characters: Use full name booru tag and proper formatting, like "karin_(blue_archive)" -> "karin \(blue_archive\)", use skin tags for better reproducing, like "karin \(bunny \(blue_archive\)". Lots of Tail/Ears-related concepts: tail censor, holding own tail, hugging own tail, holding another's tail, tail grab, tail raised, tail down, ears down, hand on own ear, tail around own leg, tail around penis, tail through clothes, tail under clothes, lifted by tail, tail biting, tail insertion, tail masturbation, holding with tail, ...and many others with natural text. The majority works perfectly, some requires rolling. Bri
Notas del creador
In depth retraining of Illustrious to achieve best prompt adherence, knowledge and state of the art performance.
Big dreams come true
The version number is just an index of current final release, not a fraction of the planned training.
Large scale finetune using gpu cluster with a dataset of ~13M pictures (~4M with natural text captions)
-
Fresh and wast knowledge about characters, concepts, styles, cultural and related things
-
The best prompt adherence among SDXL anime models at the moment of release
-
Solved main problems with tags bleeding and biases, common for Illustrious, NoobAi and other checkpoints
-
Excellent aesthetics and knowledge across a wide range of styles ( (), including hundreds of unique cherry-picked datasets from private galleries, including those received from the artists themselves)
-
High flexibility and variety without stability tradeoff
-
No more annoying watermarks for popular styles thanks to clean dataset
-
Vibrant colors and smooth gradients without trace of burning, full range even with epsilon
-
Pure training from Illustrious v0.1 without involving third-party checkpoints, Loras, tweakers, etc.
There are also some issues and changes compared to the previous version, please RTFM.
Dataset cut-off - end of April 2025.
Features and prompting:
Important change:
When you are prompting artist styles, especially mixing several, their tags MUST BE in a separate CLIP chunk. Just add BREAK after it (for A1111 and derivatives), use conditioning concat node (for Comfy) or at least put them in the very end. Otherwise, significant degradation of results is likely.
Basic:
The checkpoint works both with short-simple and long-complex prompts. However, if there are contradictory or weird things - unlike with others they won't be ignored affecting the output. No guide-rails, no safeguards, no lobotomy.
Just prompt what you want to see and don't prompt what shouldn't be on the picture. If you want to have a view from above - don't put ceiling into positive, if you want to have crop view with head out of frame - don't make detailed description of character facial features, and so on. Pretty simple but sometimes people are missing it.
Version 0.8 comes with advanced understanding of natural text prompts. It doesn't mean that you are obligated to use it, tags only - completely fine, especially because understanding of tags combinations is also improved.
Do not expect it to perform like Flux or other models based on T5 or LLM text encoders. The whole size ot SDXL checkpoint is less then only that text encoder, in addition illustrious-v0.1 which is used as the base completely forgot a lot of general things from vanilla sdxl-base.
However, even in current state it works much better, allows to do new things usually impossible without external guidance, as well making manual editing, inpainting, etc more convenient.
To achieve best performance you should keep track of CLIP chunks. In SDXL the prompt is separated into a chunks of 75 (77 including BOS and EOS) tokens, that are processing by CLIP separately, and only then are concatinating and comes as conditions to unet.
If you want to specify some features for character/object and separate them from other prompt parts - make sure they are in the same chunk and optionally separate it with BREAK. It will not solve problem of traits mixing completely, but can reduce it improving overall understanding, since text encoders on RouWei are able to process the whole sequence, not individual concepts better then others.
Dataset contains only booru-style tags and natural text expressions. Despite having a share of furries, real life photos, western media, etc. all captions have been converted to classic booru style to avoid a number of problems from mixing of different systems. So e621 tags won't be understanded properly.
Sampling parameters:
-
~1 megapixel for txt2img, any AR with resolution multiple of 32 (1024x1024, 1056x, 1152x, 1216x832,...). Euler_a, 20..28steps.
-
CFG: for epsilon version 4..9 (7 is best), for vpred version, 3..5
-
Sigmas multiply may improve results a bit, CFG++ samplers work fine. LCM/PCM/DMD/... and exotic samplers untested.
-
Some schedulers doesn't work well.
-
Highresfix - x1.5 latent + denoise 0.6 or any gan + denoise 0.3..0.55.
-
For vpred version lower CFG 3..5 is needed!
For vpred version lower CFG 3..5 is needed!
Quality classification:
Only 4 quality tags:
masterpiece, best quality
for positive and
low quality, worst quality
for negative.
Nothing else. Actually you can even omit positive and reduce negative to low quality only, since they can affect basic style and composition.
Meta tags like lowres have been removed and don't work, better not to use them. Low resolution images have been either removed or upscaled and cleaned with DAT depending on their importance.
Negative prompt:
worst quality, low quality, watermark
That's all, no need of "rusty trombone", "farting on prey" and others. Do not put tags like greyscale, monochrome in negative unless you understand what are you doing. Extra tags for brightness/colors/contrast section below can be used
Artist styles:
, (also can be found in "training data").
Used with "by " it's mandatory. It will not work properly without it.
"by " is a meta-token for styles to avoid mixing/misinterpret with tags/characters of similar or close name. This allows to have a better results for styles and at the same time avoid random style fluctuation that you may observe in other checkpoints.
Multiple give very interesting results, can be controlled with prompt weights and spells.
YOU MUST ADD BREAK after artists/style tags (for A1111) or concat conditioning (for Comfy) or put them in the very end of your prompt.
For example:
by kantoku, by wlop, best quality, masterpiece BREAK 1girl, ...
General styles:
2.5d, anime screencap, bold line, sketch, cgi, digital painting, flat colors, smooth shading, minimalistic, ink style, oil st
La escala va de 0° a 9,999°. Todo lo que está por debajo de 7,000° se reserva para modelos que ninguna fuente reporta aún, que llevan un número provisional ahí para que las listas se mantengan completas. 7,000° es donde empiezan los datos medidos: un modelo con datos reales pero casi sin descargas se sitúa en el piso, y las mediciones llenan los grados por encima. El piso no dice nada sobre el modelo; solo los grados por encima lo hacen, y son los que separan un modelo de otro.
+1,164°
Descargas en Civitai
6,582 descargas de esta versión exacta en Civitai. Las descargas son el ingrediente más pesado y se cuentan en escala logarítmica: diez veces las descargas suman los mismos 300°, así que un modelo con un millón de descargas no es mil veces más popular que uno con mil. Las seis fuentes de descargas comparten ese término, repartido entre ellas según sus conteos.
+414°
Me gusta
578 me gusta y pulgares arriba en todas las fuentes. Un me gusta pesa la mitad de una descarga, en la misma escala logarítmica.
+49°
Tasa de adopción
Unos 3 descargas al día, medidos entre dos lecturas de las fuentes, nunca estimados a partir de un promedio de toda la vida. La velocidad pesa un cuarto del término de descargas, así que un aumento reciente se nota sin que un pico de un día supere años de uso.
+150°
Modelo completo
+150° porque este es un modelo completo: un checkpoint, los pesos mismos. Un LoRA o un embedding es un complemento a los pesos de otro y no supera en rango a un checkpoint con igual popularidad.
−497°
Antigüedad
−497° porque los pesos SDXL salieron en 2023. Cada modelo hereda la antigüedad de los pesos en los que se basa: 150° por año, hasta 750°, y sigue creciendo hasta entonces. Sin esto, la cima de la lista serían checkpoints de 2022 y 2023 basados en descargas que tuvieron años para acumularse.
Mostrar desglose detallado
Cada número en este sitio se puede verificar. La puntuación de popularidad de este modelo es 8,280°, y aquí se construye un ingrediente a la vez, con el total acumulado después de cada uno: el piso, los grados que añade cada fuente, el bono por el tipo de modelo y lo que la antigüedad de sus pesos resta. Los colores son las bandas del gráfico de arriba. El glosario al final define cada término.
1
Empieza en el piso.
Por qué 7,000° y no cero: la escala va de 0° a 9,999°, y la parte por debajo de 7,000° está reservada para modelos que ninguna fuente reporta aún, que llevan un número provisional ahí para que las listas se mantengan completas y nunca superen a un modelo con datos. 7,000° es donde empiezan los datos medidos. Un modelo con datos reales pero casi sin descargas está aquí; todo lo que sigue es medición, y el espacio sobre el piso tiene diez pasos de diez veces más descargas a 300° cada uno. El piso es igual para todos los modelos, así que no decide nada; los grados por encima sí.
7,000°
total acumulado
2
Suma las descargas.
6,582 equivalentes a descargas en total, de Descargas en Civitai. Diez veces las descargas suman el mismo 300°, así que el tamaño importa pero nunca domina la puntuación.
+1,164°
8,164°
total acumulado
3
Suma los likes.
578 likes y pulgares arriba, con la mitad del peso de una descarga.
+414°
8,578°
total acumulado
4
Añade la tasa de adopción.
Unos 3 descargas al día ahora mismo, medido entre dos lecturas, con un cuarto del peso.
+49°
8,627°
total acumulado
5
Bono por un modelo completo.
Un checkpoint lleva los pesos en sí; los complementos no superan a uno con igual popularidad.
+150°
8,777°
total acumulado
6
Quita la antigüedad.
Los pesos de SDXL salieron en 2023: 150° por año, hasta 750°, creciendo hasta entonces.
−497°
8,280°
total acumulado
=
La puntuación heat.
Dónde está este modelo en cada lista de este sitio. Nada más la ajusta.
8,280°
Glosario: los términos usados aquí
Puntuación heat
Un número que muestra cuánto se usa y quiere un modelo ahora mismo, de 0° a 9,999°. Cada lista en este sitio que dice más popular está ordenada por esto y nada más.
Piso
Los 7,000° con los que empieza todo modelo con datos reales. La escala va de 0° a 9,999°; la parte bajo el piso está reservada para sustitutos (modelos sin datos), para que un modelo con datos siempre esté por encima de uno sin. El piso es igual para todos y no decide nada; los grados sobre él son la medida.
Equivalentes a descargas
Todo lo que la puntuación trata como una descarga, sumado: las descargas mismas, cada seeder de torrent como 1,000, cada imagen de AI Horde y cada ejecución en un sitio de generación como uno.
Escala logarítmica
Cuenta de a decenas, no de a uno: pasar de 1,000 a 10,000 descargas suma los mismos grados que pasar de 10,000 a 100,000. Evita que los gigantes opaquen todo lo demás.
Likes
Pulgares arriba y likes de todas las fuentes, valen la mitad de una descarga cada uno en la escala logarítmica.
Tasa de adopción
Cuántas descargas al día recibe un modelo ahora mismo, según la diferencia entre dos lecturas de una fuente. Un cuarto del peso del término de descarga.
Medido y estimado
Medido significa que hay dos lecturas de una fuente y la diferencia es real. Estimado significa que solo se conoce el total de hoy y el pasado se distribuye a lo largo de la vida del modelo; el sitio indica cuál está mostrando.
Seeder
Alguien que mantiene una copia de los pesos en línea para que otros la descarguen por torrent, o un espejo alojado que hace lo mismo. Cada uno cuenta como 1,000 descargas.
AI Horde
Una red de voluntarios que genera imágenes gratis en computadoras donadas. El número de imágenes que ha hecho con un modelo es público, y cada una cuenta como una descarga.
Sitios de generación
Sitios que alojan sus propias copias de un modelo y permiten que la gente genere con él, como PixAI, SeaArt y Yodayo. Sus descargas cuentan igual que las de Civitai y cada generación cuenta como una descarga.
Tokens de OpenRouter
Un modelo de texto servido mediante una API, como Claude o GPT, no tiene pesos para descargar, por lo que su uso se mide en tokens: fragmentos de texto que leyó y escribió a través de OpenRouter, una puerta de acceso que usan muchas apps, durante los últimos 30 días. Cada 10,000,000 tokens cuentan como una descarga. Fuente: OpenRouter (openrouter.ai/rankings), CC BY 4.0.
Modelo completo (checkpoint)
Los pesos en sí, el archivo que genera por sí solo. Tiene un bono porque los complementos dependen de él.
LoRA y embedding
Archivos pequeños que dirigen los pesos de otro hacia un estilo, personaje o concepto. No pueden funcionar solos.
Familia y pesos
La base sobre la que se construye un modelo, como SD 1.5, SDXL, Flux o Wan. Cada modelo hereda la fecha de lanzamiento de los pesos de su familia.
Antigüedad
Grados descontados según hace cuánto salieron los pesos de la familia: 150° por año, hasta 750°. Mantiene las descargas antiguas que tuvieron años para acumularse congelando la cima de la lista.
Impulso de familia
Un pequeño empujón limitado para LoRAs de una familia que este sitio está promoviendo ahora, siempre listado en el desglose.
Puntaje provisional
Un número estable por debajo del mínimo dado a un modelo que aún no tiene reportes de fuentes, para que las listas estén completas. Nunca se posiciona por encima de un modelo con datos.
¡Nuevo! (periodo de gracia)
Un modelo con menos de 7 días muestra ¡Nuevo! en lugar de una puntuación y no ocupa lugar en los rankings. Su puntuación se calcula desde el primer día, pero un modelo de un día crece más rápido que cualquier otro, así que sin este periodo el #1 de la semana siempre sería el que salió ayer en vez del que se mantuvo una semana.
Tendencia
Cómo el crecimiento de un modelo en un período se compara con el crecimiento típico de modelos en ese mismo período. Más rápido que lo típico se lee como subida, más lento como bajada.
Modelo típico
El punto medio del catálogo: la mitad de los modelos con cifras crecieron más rápido en el período, la otra mitad más lento.
Cómo se ha movido la popularidad de este modelo frente al resto del catálogo: su crecimiento en descargas, likes y uso en cada periodo, medido contra el crecimiento típico de un modelo en el mismo periodo, con su puntuación de calor en ese momento. Por encima del crecimiento típico se lee como un aumento, por debajo como una caída. El pasado se reconstruye a partir de los totales de hoy, el primer día del modelo y su velocidad de descarga medida cuando hay dos lecturas; un modelo que no existía al inicio de un periodo muestra n/a.
Renders de ejemplo
Prompts y ajustes compartidos por quienes hicieron estos renders en Civitai. Elige un render para ver cómo se hizo.
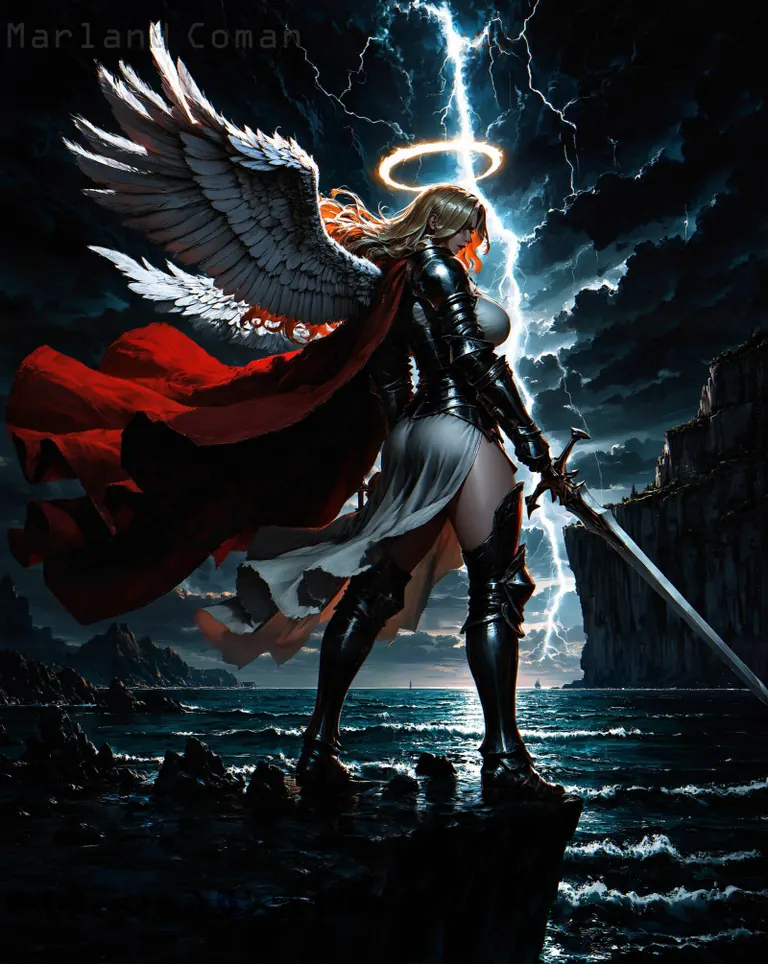
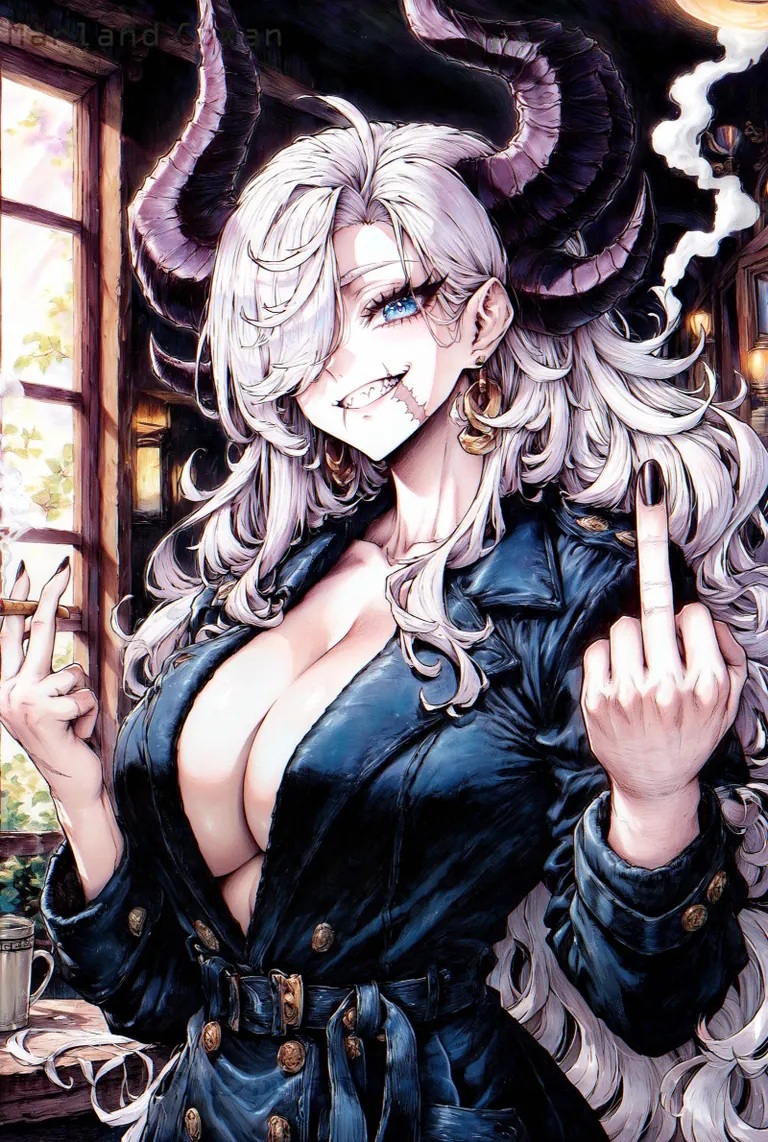
1girl, solo, angel, angel wings, white wings, blonde hair, long hair, blue eyes, large breasts, determined, closed eyes, hair over one eye, white dress, armor, red cape, sword, holding sword, standing, legs apart, wind, stormy sky, ocean, cliff, lightning, glowing eyes, halo, from side
by ranko no ane, masterpiece, best quality, BREAK,
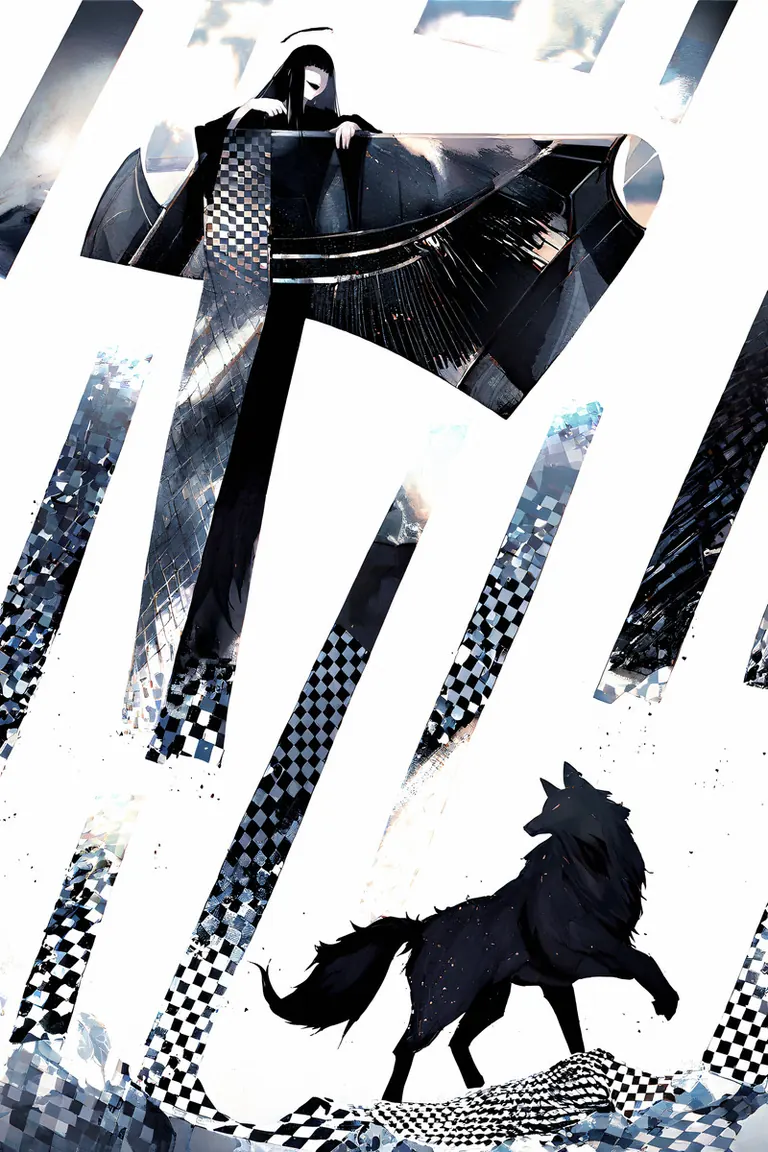
checkered sand, 1girl, long black hair, faceless, black robe, pale skin, leaning on object, curled fingers, wide smile, evil smile,
collage, photo bashing, photoshop \(medium\), BREAK,
black wolf, giant piano, black streaks, dithering, zoom layer, halo,
Contexto de 1,050,000 tokens · $0.43/M entrada, $0.87/M salida
MiMo-V2.6-Pro es el modelo insignia de Xiaomi: un sistema sparse Mixture-of-Experts con 1.02 billones de parámetros totales (42 mil millones activados) que maneja texto, imagen, video y audio en un solo modelo. Su característica definitoria es una pipeline de aprendizaje por refuerzo diseñada para mejorar continuamente mediante exploración en lugar de fine-tuning separado por dominio. Es ideal para equipos que ejecutan flujos de trabajo agentes complejos, código con contexto largo o tareas de investigación, y para cualquiera que quiera un modelo de frontera con pesos abiertos a un precio inferior a un dólar por millón.
Conocido por
Verdadero omnimodal: texto, imagen, video y audio manejados nativamente en un solo modelo
Ventana de contexto de 1 millón de tokens — suficiente para repositorios completos o ejecuciones multi-sesión de agentes
Una sola ejecución mixta de RL para tareas de codificación, visuales, generales y de ciberseguridad
Un modelo serio de frontera con pesos abiertos para trabajo agente y con contexto largo — el precio es adecuado, pero el requerimiento de hardware no es trivial.Veredicto del capitán