Les applications qui supportent les tags ModelTrends vous permettent d'exécuter/installer des modèles en copiant ce code dans votre prompt sans aucune configuration. Cherchez notre icône dans les applications qui le supportent, comme Prism (ci-dessous).
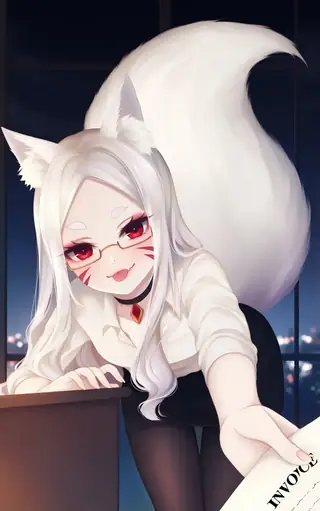
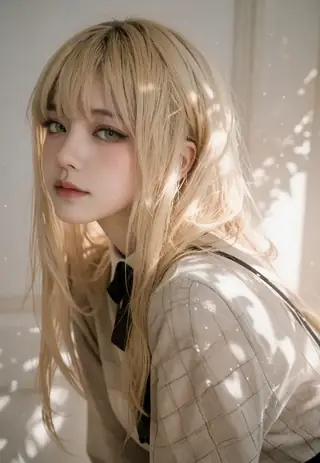
by Minthybasis - Advanced illustrious model, somewhere between an anime and furry style. Hard to work with but gives incredible range of lightning and poses for those that are up for the challenge. This is a large scale fine-tune with 4.5 million pictures using danbooru tags, so e621 isn't understood. Use guidance 5-7 at 20-30 steps. To get a sharp photo, render three steps: upscale by 1.5x at strength 0.6, then again at 0.3x at strength 0.55. General styles: 2.5d, anime screencap, bold line, sketch, cgi, digital painting, flat colors, smooth shading, minimalistic, ink style, oil style,…by Minthybasis - Advanced illustrious model, somewhere between an anime and furry style. Hard to work with but gives incredible range of lightning and poses for those that are up for the challenge. This is a large scale fine-tune with 4.5 million pictures using danbooru tags, so e621 isn't understood. Use guidance 5-7 at 20-30 steps. To get a sharp photo, render three steps: upscale by 1.5x at strength 0.6, then again at 0.3x at strength 0.55. General styles: 2.5d, anime screencap, bold line, sketch, cgi, digital painting, flat colors, smooth shading, minimalistic, ink style, oil style, pastel style Booru tags styles: 1950s (style), 1960s (style), 1970s (style), 1980s (style), 1990s (style), 1990s (style), animification, art nouveau, pinup (style), toon (style), western comics (style), nihonga, shikishi, minimalism, fine art parody and everything from this group. Characters: Use full name booru tag and proper formatting, like "karin_(blue_archive)" -> "karin \(blue_archive\)", use skin tags for better reproducing, like "karin \(bunny \(blue_archive\)". Lots of Tail/Ears-related concepts: tail censor, holding own tail, hugging own tail, holding another's tail, tail grab, tail raised, tail down, ears down, hand on own ear, tail around own leg, tail around penis, tail through clothes, tail under clothes, lifted by tail, tail biting, tail insertion, tail masturbation, holding with tail, ...and many others with natural text. The majority works perfectly, some requires rolling. Bri
Notes du créateur
In depth retraining of Illustrious to achieve best prompt adherence, knowledge and state of the art performance.
Big dreams come true
The version number is just an index of current final release, not a fraction of the planned training.
Large scale finetune using gpu cluster with a dataset of ~13M pictures (~4M with natural text captions)
-
Fresh and wast knowledge about characters, concepts, styles, cultural and related things
-
The best prompt adherence among SDXL anime models at the moment of release
-
Solved main problems with tags bleeding and biases, common for Illustrious, NoobAi and other checkpoints
-
Excellent aesthetics and knowledge across a wide range of styles ( (), including hundreds of unique cherry-picked datasets from private galleries, including those received from the artists themselves)
-
High flexibility and variety without stability tradeoff
-
No more annoying watermarks for popular styles thanks to clean dataset
-
Vibrant colors and smooth gradients without trace of burning, full range even with epsilon
-
Pure training from Illustrious v0.1 without involving third-party checkpoints, Loras, tweakers, etc.
There are also some issues and changes compared to the previous version, please RTFM.
Dataset cut-off - end of April 2025.
Features and prompting:
Important change:
When you are prompting artist styles, especially mixing several, their tags MUST BE in a separate CLIP chunk. Just add BREAK after it (for A1111 and derivatives), use conditioning concat node (for Comfy) or at least put them in the very end. Otherwise, significant degradation of results is likely.
Basic:
The checkpoint works both with short-simple and long-complex prompts. However, if there are contradictory or weird things - unlike with others they won't be ignored affecting the output. No guide-rails, no safeguards, no lobotomy.
Just prompt what you want to see and don't prompt what shouldn't be on the picture. If you want to have a view from above - don't put ceiling into positive, if you want to have crop view with head out of frame - don't make detailed description of character facial features, and so on. Pretty simple but sometimes people are missing it.
Version 0.8 comes with advanced understanding of natural text prompts. It doesn't mean that you are obligated to use it, tags only - completely fine, especially because understanding of tags combinations is also improved.
Do not expect it to perform like Flux or other models based on T5 or LLM text encoders. The whole size ot SDXL checkpoint is less then only that text encoder, in addition illustrious-v0.1 which is used as the base completely forgot a lot of general things from vanilla sdxl-base.
However, even in current state it works much better, allows to do new things usually impossible without external guidance, as well making manual editing, inpainting, etc more convenient.
To achieve best performance you should keep track of CLIP chunks. In SDXL the prompt is separated into a chunks of 75 (77 including BOS and EOS) tokens, that are processing by CLIP separately, and only then are concatinating and comes as conditions to unet.
If you want to specify some features for character/object and separate them from other prompt parts - make sure they are in the same chunk and optionally separate it with BREAK. It will not solve problem of traits mixing completely, but can reduce it improving overall understanding, since text encoders on RouWei are able to process the whole sequence, not individual concepts better then others.
Dataset contains only booru-style tags and natural text expressions. Despite having a share of furries, real life photos, western media, etc. all captions have been converted to classic booru style to avoid a number of problems from mixing of different systems. So e621 tags won't be understanded properly.
Sampling parameters:
-
~1 megapixel for txt2img, any AR with resolution multiple of 32 (1024x1024, 1056x, 1152x, 1216x832,...). Euler_a, 20..28steps.
-
CFG: for epsilon version 4..9 (7 is best), for vpred version, 3..5
-
Sigmas multiply may improve results a bit, CFG++ samplers work fine. LCM/PCM/DMD/... and exotic samplers untested.
-
Some schedulers doesn't work well.
-
Highresfix - x1.5 latent + denoise 0.6 or any gan + denoise 0.3..0.55.
-
For vpred version lower CFG 3..5 is needed!
For vpred version lower CFG 3..5 is needed!
Quality classification:
Only 4 quality tags:
masterpiece, best quality
for positive and
low quality, worst quality
for negative.
Nothing else. Actually you can even omit positive and reduce negative to low quality only, since they can affect basic style and composition.
Meta tags like lowres have been removed and don't work, better not to use them. Low resolution images have been either removed or upscaled and cleaned with DAT depending on their importance.
Negative prompt:
worst quality, low quality, watermark
That's all, no need of "rusty trombone", "farting on prey" and others. Do not put tags like greyscale, monochrome in negative unless you understand what are you doing. Extra tags for brightness/colors/contrast section below can be used
Artist styles:
, (also can be found in "training data").
Used with "by " it's mandatory. It will not work properly without it.
"by " is a meta-token for styles to avoid mixing/misinterpret with tags/characters of similar or close name. This allows to have a better results for styles and at the same time avoid random style fluctuation that you may observe in other checkpoints.
Multiple give very interesting results, can be controlled with prompt weights and spells.
YOU MUST ADD BREAK after artists/style tags (for A1111) or concat conditioning (for Comfy) or put them in the very end of your prompt.
For example:
by kantoku, by wlop, best quality, masterpiece BREAK 1girl, ...
General styles:
2.5d, anime screencap, bold line, sketch, cgi, digital painting, flat colors, smooth shading, minimalistic, ink style, oil st
L’échelle va de 0° à 9 999°. Tout ce qui est en dessous de 7,000° est réservé aux modèles dont aucune source ne rapporte encore de données, ils portent un nombre de remplacement pour que les listes restent complètes. 7,000° est le point où les données mesurées commencent : un modèle avec de vraies données mais presque aucun téléchargement est au plancher, et les mesures remplissent les degrés au-dessus. Le plancher ne dit rien sur le modèle ; seuls les degrés au-dessus le font, et ce sont eux qui différencient un modèle d’un autre.
+1,164°
Téléchargements Civitai
6,582 téléchargements de cette version exacte sur Civitai. Les téléchargements sont l'ingrédient le plus lourd et sont comptés sur une échelle logarithmique : multiplier par dix les téléchargements ajoute 300° au score, donc un modèle avec un million de téléchargements n'est pas mille fois plus chaud qu'un avec mille. Les six sources de téléchargements partagent ce terme, réparti proportionnellement à leurs comptes.
+414°
Likes
578 likes et pouces levés sur toutes les sources. Un like vaut la moitié d’un téléchargement, sur la même échelle logarithmique.
+49°
Taux d’adoption
Environ 3 téléchargements par jour, mesurés entre deux relevés des sources, jamais estimés à partir d’une moyenne sur la durée. La vitesse compte pour un quart du terme téléchargement, donc une poussée récente apparaît sans qu’un pic d’un jour dépasse des années d’usage.
+150°
Modèle complet
+150° parce que c’est un modèle complet : un checkpoint, les poids eux-mêmes. Un LoRA ou un embedding est un ajout aux poids de quelqu’un d’autre et ne dépasse pas un checkpoint de popularité égale.
−497°
Âge
−497° parce que les poids SDXL sont sortis en 2023. Chaque modèle hérite de l’âge des poids sur lesquels il est construit : 150° par an, jusqu’à 750°, et ça continue de grandir jusqu’à ce seuil. Sans ça, le haut de la liste serait occupé par des checkpoints de 2022 et 2023 grâce aux téléchargements accumulés sur des années.
Afficher le détail
Chaque chiffre sur ce site peut être vérifié. Le score de popularité de ce modèle est de 8,280°, et voici comment il est construit, ingrédient par ingrédient, avec le total cumulé après chaque étape : le plancher, les degrés ajoutés par chaque source, le bonus pour le type de modèle et ce que l’âge de ses poids enlève. Les couleurs correspondent aux bandes du graphique ci-dessus. Le glossaire à la fin définit chaque terme.
1
Commence au plancher.
Pourquoi 7,000° et pas zéro : l’échelle va de 0° à 9 999°, et la partie en dessous de 7,000° est réservée aux modèles dont aucune source ne rapporte encore de données, qui portent un nombre de remplacement pour que les listes restent complètes et ne dépassent jamais un modèle avec données. 7,000° est le point où les données mesurées commencent. Un modèle avec de vraies données mais presque aucun téléchargement est ici ; tout ce qui suit est une mesure, et l’espace au-dessus du plancher contient dix paliers de dix fois plus de téléchargements à 300° chacun. Le plancher est le même pour tous les modèles, donc il ne décide rien ; ce sont les degrés au-dessus qui le font.
7,000°
total en cours
2
Ajoute les téléchargements.
6,582 équivalents de téléchargement au total, venant de Téléchargements Civitai. Multiplier les téléchargements par dix ajoute le même 300°, donc la taille compte mais ne domine jamais le score.
+1,164°
8,164°
total en cours
3
Ajoute les likes.
578 likes et pouces levés, à moitié du poids d’un téléchargement.
+414°
8,578°
total en cours
4
Ajoute le taux d’adoption.
Environ 3 téléchargements par jour en ce moment, mesurés entre deux relevés, à un quart du poids.
+49°
8,627°
total en cours
5
Bonus pour un modèle complet.
Un checkpoint contient les poids eux-mêmes ; les add-ons ne surpassent pas un modèle de popularité égale.
+150°
8,777°
total en cours
6
Enlève l’âge.
Les poids SDXL sont sortis en 2023 : 150° par an, jusqu’à 750°, qui augmente jusqu’à ce moment.
−497°
8,280°
total en cours
=
Le score de chaleur.
La place de ce modèle dans chaque liste de ce site. Rien d’autre ne le modifie.
8,280°
Glossaire : les termes utilisés ici
Score de chaleur
Un seul chiffre pour montrer à quel point un modèle est utilisé et recherché en ce moment, de 0° à 9 999°. Chaque liste sur ce site qui dit « les plus chauds » est triée selon ce score et rien d’autre.
Plancher
Les 7 000° que chaque modèle avec des données réelles commence avec. L’échelle va de 0° à 9 999° ; la partie sous le plancher est réservée aux remplaçants (modèles sans données), pour qu’un modèle avec données soit toujours mieux classé qu’un sans. Le plancher est le même pour tous et ne décide rien ; les degrés au-dessus sont la mesure.
Équivalents de téléchargement
Tout ce que le score considère comme un téléchargement, additionné : les téléchargements eux-mêmes, chaque seeder torrent comme 1 000, chaque image AI Horde et chaque exécution sur un site de génération comme un.
Échelle logarithmique
On compte par dizaines, pas par unités : passer de 1 000 à 10 000 téléchargements ajoute autant de degrés que passer de 10 000 à 100 000. Ça évite que les géants écrasent tout le reste.
Likes
Les pouces levés et likes de toutes sources, valant chacun la moitié d’un téléchargement sur l’échelle logarithmique.
Taux d’adoption
Combien de téléchargements par jour un modèle obtient en ce moment, calculé à partir de la différence entre deux relevés d’une source. Un quart du poids du terme téléchargement.
Mesuré et estimé
Mesuré signifie qu'il existe deux relevés d'une source et que la différence est réelle. Estimé signifie que seul le total d'aujourd'hui est connu et que le passé est réparti sur la durée de vie du modèle ; le site indique lequel est affiché.
Seeder
Quelqu'un qui garde une copie des poids en ligne pour que d'autres puissent les télécharger via un torrent, ou un miroir hébergé qui fait la même chose. Chacun compte comme 1 000 téléchargements.
AI Horde
Un réseau de bénévoles qui génère des images gratuitement sur des ordinateurs donnés. Le nombre d'images créées avec un modèle est public, et chacune compte comme un téléchargement.
Sites de génération
Sites qui hébergent leurs propres copies d'un modèle et permettent aux gens de générer avec, comme PixAI, SeaArt et Yodayo. Leurs téléchargements comptent comme ceux de Civitai et chaque génération compte comme un téléchargement.
Tokens OpenRouter
Un modèle texte servi via une API, comme Claude ou GPT, n'a pas de poids à télécharger, son usage est donc mesuré en tokens : les morceaux de texte lus et écrits via OpenRouter, une passerelle utilisée par de nombreuses applications, sur les 30 derniers jours. Chaque 10,000,000 tokens compte comme un téléchargement. Source : OpenRouter (openrouter.ai/rankings), CC BY 4.0.
Modèle complet (checkpoint)
Les poids eux-mêmes, le fichier qui génère tout seul. Il reçoit un bonus parce que les add-ons en dépendent.
LoRA et embedding
Petits fichiers add-on qui orientent les poids de quelqu'un d'autre vers un style, un personnage ou un concept. Ils ne peuvent pas fonctionner seuls.
Famille et poids
La base sur laquelle un modèle est construit, comme SD 1.5, SDXL, Flux ou Wan. Chaque modèle hérite de la date de sortie des poids de sa famille.
Âge
Degrés retirés selon l'ancienneté des poids de la famille : 150° par an, jusqu'à 750°. Cela garde les anciens téléchargements qui ont eu des années pour s'accumuler en haut de la liste.
Boost de la famille
Une petite poussée limitée pour les LoRA d'une famille que ce site met en avant en ce moment, toujours listée dans la répartition.
Score de remplacement
Un nombre stable en dessous du minimum donné à un modèle dont aucune source ne rapporte encore, pour que les listes restent complètes. Il ne dépasse jamais un modèle avec des données.
Nouveau ! (période de grâce)
Un modèle âgé de moins de 7 jours affiche Nouveau ! au lieu d'un score et ne figure pas dans le classement. Son score est calculé dès le premier jour, mais un modèle d'un jour grandit plus vite que tout, donc sans attente le #1 de la semaine serait toujours celui sorti hier plutôt que celui qui tient depuis une semaine.
Tendance
Comment la croissance d'un modèle sur une période se compare à la croissance typique d'un modèle sur la même période. Plus rapide que la moyenne signifie une hausse, plus lente une baisse.
Modèle typique
Le milieu du catalogue : la moitié des modèles avec un chiffre ont grandi plus vite sur la période, l'autre moitié plus lentement.
Voici comment la popularité de ce modèle a évolué par rapport au reste du catalogue : sa croissance en téléchargements, likes et utilisation à chaque période, comparée à la croissance typique des modèles sur la même période, avec son score de chaleur à ce moment-là. Au-dessus de la croissance typique, c’est une hausse, en dessous, une baisse. Le passé est reconstitué à partir des totaux d’aujourd’hui, du premier jour du modèle et de sa vitesse de téléchargement mesurée quand il y a deux relevés ; un modèle qui n’existait pas au début d’une période affiche n/a.
Rendus d'exemple
Prompts et réglages partagés par les personnes qui ont réalisé ces rendus sur Civitai. Choisissez un rendu pour voir comment il a été fait.
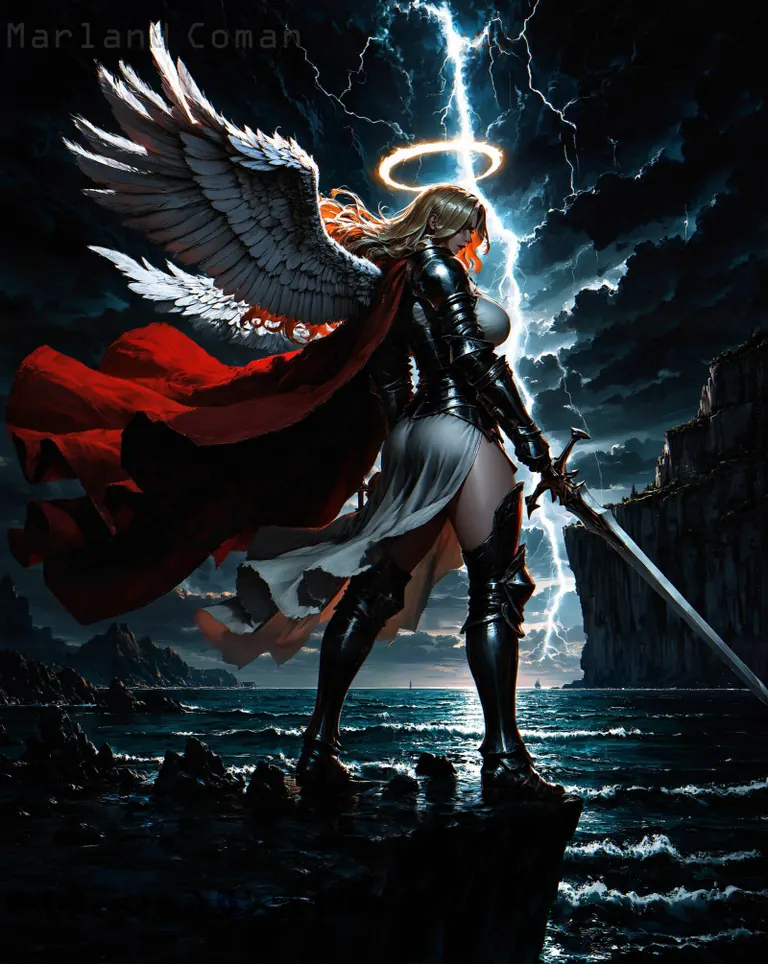
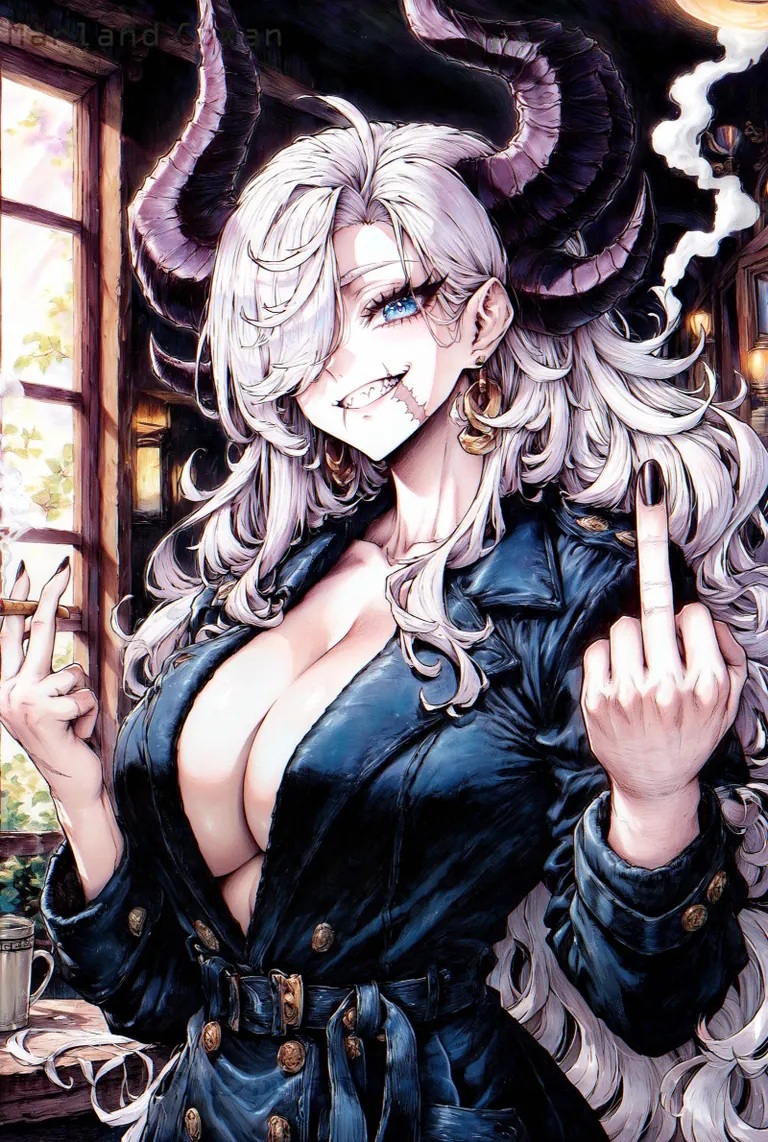
1girl, solo, angel, angel wings, white wings, blonde hair, long hair, blue eyes, large breasts, determined, closed eyes, hair over one eye, white dress, armor, red cape, sword, holding sword, standing, legs apart, wind, stormy sky, ocean, cliff, lightning, glowing eyes, halo, from side
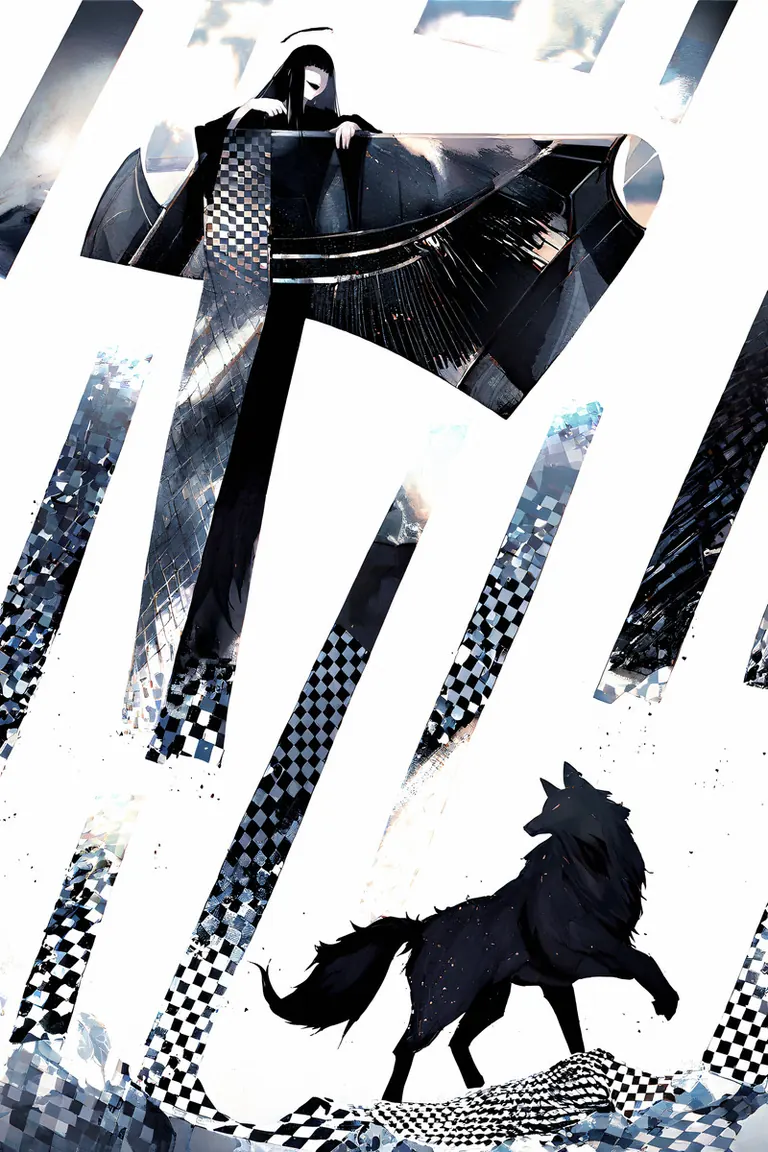
by ranko no ane, masterpiece, best quality, BREAK,
checkered sand, 1girl, long black hair, faceless, black robe, pale skin, leaning on object, curled fingers, wide smile, evil smile,
collage, photo bashing, photoshop \(medium\), BREAK,
black wolf, giant piano, black streaks, dithering, zoom layer, halo,
Contexte de 1,050,000 tokens · entrée $0.43/M, sortie $0.87/M
MiMo-V2.6-Pro est le modèle phare de Xiaomi : un système sparse Mixture-of-Experts avec 1,02 trillion de paramètres totaux (42 milliards activés) qui gère texte, image, vidéo et audio dans un seul modèle. Sa caractéristique principale est un pipeline d’apprentissage par renforcement conçu pour s’améliorer continuellement par exploration plutôt que par fine-tuning séparé par domaine. Il convient aux équipes exécutant des workflows agentiques complexes, du code à long contexte ou des tâches de recherche, ainsi qu’à quiconque souhaite un modèle de pointe à poids ouverts à un prix inférieur au dollar par million.
Connu pour
Véritable omnimodal : texte, image, vidéo et audio gérés nativement dans un seul modèle
Fenêtre de contexte d’un million de tokens — assez longue pour des dépôts complets ou des sessions agent multi-tours
Unique entraînement RL mixte couvrant codage, visuel, général et cybersécurité
Un modèle de pointe sérieux à poids ouverts pour le travail agentique et à long contexte — le prix est raisonnable, mais la demande matérielle n’est pas anodine.Verdict du capitaine