Aplikacje obsługujące tagi ModelTrends pozwalają uruchamiać/instalować modele, kopiując ten kod do swojego promptu bez żadnej konfiguracji. Szukaj naszej ikony w aplikacjach, które to wspierają, jak Prism (poniżej).
by Minthybasis - Advanced illustrious model, somewhere between an anime and furry style. Hard to work with but gives incredible range of lightning and poses for those that are up for the challenge. This is a large scale fine-tune with 4.5 million pictures using danbooru tags, so e621 isn't understood. Use guidance 5-7 at 20-30 steps. To get a sharp photo, render three steps: upscale by 1.5x at strength 0.6, then again at 0.3x at strength 0.55. General styles: 2.5d, anime screencap, bold line, sketch, cgi, digital painting, flat colors, smooth shading, minimalistic, ink style, oil style,…by Minthybasis - Advanced illustrious model, somewhere between an anime and furry style. Hard to work with but gives incredible range of lightning and poses for those that are up for the challenge. This is a large scale fine-tune with 4.5 million pictures using danbooru tags, so e621 isn't understood. Use guidance 5-7 at 20-30 steps. To get a sharp photo, render three steps: upscale by 1.5x at strength 0.6, then again at 0.3x at strength 0.55. General styles: 2.5d, anime screencap, bold line, sketch, cgi, digital painting, flat colors, smooth shading, minimalistic, ink style, oil style, pastel style Booru tags styles: 1950s (style), 1960s (style), 1970s (style), 1980s (style), 1990s (style), 1990s (style), animification, art nouveau, pinup (style), toon (style), western comics (style), nihonga, shikishi, minimalism, fine art parody and everything from this group. Characters: Use full name booru tag and proper formatting, like "karin_(blue_archive)" -> "karin \(blue_archive\)", use skin tags for better reproducing, like "karin \(bunny \(blue_archive\)". Lots of Tail/Ears-related concepts: tail censor, holding own tail, hugging own tail, holding another's tail, tail grab, tail raised, tail down, ears down, hand on own ear, tail around own leg, tail around penis, tail through clothes, tail under clothes, lifted by tail, tail biting, tail insertion, tail masturbation, holding with tail, ...and many others with natural text. The majority works perfectly, some requires rolling. Bri
Notatki twórcy
In depth retraining of Illustrious to achieve best prompt adherence, knowledge and state of the art performance.
Big dreams come true
The version number is just an index of current final release, not a fraction of the planned training.
Large scale finetune using gpu cluster with a dataset of ~13M pictures (~4M with natural text captions)
-
Fresh and wast knowledge about characters, concepts, styles, cultural and related things
-
The best prompt adherence among SDXL anime models at the moment of release
-
Solved main problems with tags bleeding and biases, common for Illustrious, NoobAi and other checkpoints
-
Excellent aesthetics and knowledge across a wide range of styles ( (), including hundreds of unique cherry-picked datasets from private galleries, including those received from the artists themselves)
-
High flexibility and variety without stability tradeoff
-
No more annoying watermarks for popular styles thanks to clean dataset
-
Vibrant colors and smooth gradients without trace of burning, full range even with epsilon
-
Pure training from Illustrious v0.1 without involving third-party checkpoints, Loras, tweakers, etc.
There are also some issues and changes compared to the previous version, please RTFM.
Dataset cut-off - end of April 2025.
Features and prompting:
Important change:
When you are prompting artist styles, especially mixing several, their tags MUST BE in a separate CLIP chunk. Just add BREAK after it (for A1111 and derivatives), use conditioning concat node (for Comfy) or at least put them in the very end. Otherwise, significant degradation of results is likely.
Basic:
The checkpoint works both with short-simple and long-complex prompts. However, if there are contradictory or weird things - unlike with others they won't be ignored affecting the output. No guide-rails, no safeguards, no lobotomy.
Just prompt what you want to see and don't prompt what shouldn't be on the picture. If you want to have a view from above - don't put ceiling into positive, if you want to have crop view with head out of frame - don't make detailed description of character facial features, and so on. Pretty simple but sometimes people are missing it.
Version 0.8 comes with advanced understanding of natural text prompts. It doesn't mean that you are obligated to use it, tags only - completely fine, especially because understanding of tags combinations is also improved.
Do not expect it to perform like Flux or other models based on T5 or LLM text encoders. The whole size ot SDXL checkpoint is less then only that text encoder, in addition illustrious-v0.1 which is used as the base completely forgot a lot of general things from vanilla sdxl-base.
However, even in current state it works much better, allows to do new things usually impossible without external guidance, as well making manual editing, inpainting, etc more convenient.
To achieve best performance you should keep track of CLIP chunks. In SDXL the prompt is separated into a chunks of 75 (77 including BOS and EOS) tokens, that are processing by CLIP separately, and only then are concatinating and comes as conditions to unet.
If you want to specify some features for character/object and separate them from other prompt parts - make sure they are in the same chunk and optionally separate it with BREAK. It will not solve problem of traits mixing completely, but can reduce it improving overall understanding, since text encoders on RouWei are able to process the whole sequence, not individual concepts better then others.
Dataset contains only booru-style tags and natural text expressions. Despite having a share of furries, real life photos, western media, etc. all captions have been converted to classic booru style to avoid a number of problems from mixing of different systems. So e621 tags won't be understanded properly.
Sampling parameters:
-
~1 megapixel for txt2img, any AR with resolution multiple of 32 (1024x1024, 1056x, 1152x, 1216x832,...). Euler_a, 20..28steps.
-
CFG: for epsilon version 4..9 (7 is best), for vpred version, 3..5
-
Sigmas multiply may improve results a bit, CFG++ samplers work fine. LCM/PCM/DMD/... and exotic samplers untested.
-
Some schedulers doesn't work well.
-
Highresfix - x1.5 latent + denoise 0.6 or any gan + denoise 0.3..0.55.
-
For vpred version lower CFG 3..5 is needed!
For vpred version lower CFG 3..5 is needed!
Quality classification:
Only 4 quality tags:
masterpiece, best quality
for positive and
low quality, worst quality
for negative.
Nothing else. Actually you can even omit positive and reduce negative to low quality only, since they can affect basic style and composition.
Meta tags like lowres have been removed and don't work, better not to use them. Low resolution images have been either removed or upscaled and cleaned with DAT depending on their importance.
Negative prompt:
worst quality, low quality, watermark
That's all, no need of "rusty trombone", "farting on prey" and others. Do not put tags like greyscale, monochrome in negative unless you understand what are you doing. Extra tags for brightness/colors/contrast section below can be used
Artist styles:
, (also can be found in "training data").
Used with "by " it's mandatory. It will not work properly without it.
"by " is a meta-token for styles to avoid mixing/misinterpret with tags/characters of similar or close name. This allows to have a better results for styles and at the same time avoid random style fluctuation that you may observe in other checkpoints.
Multiple give very interesting results, can be controlled with prompt weights and spells.
YOU MUST ADD BREAK after artists/style tags (for A1111) or concat conditioning (for Comfy) or put them in the very end of your prompt.
For example:
by kantoku, by wlop, best quality, masterpiece BREAK 1girl, ...
General styles:
2.5d, anime screencap, bold line, sketch, cgi, digital painting, flat colors, smooth shading, minimalistic, ink style, oil st
Skala idzie od 0° do 9 999°. Wszystko poniżej 7,000° jest zarezerwowane dla modeli, o których żadne źródło jeszcze nie raportuje, które mają tam zastępczą wartość, by listy były kompletne. 7,000° to punkt startowy dla danych pomiarowych: model z prawdziwymi danymi, ale prawie bez pobrań, stoi na tej podstawie, a pomiary wypełniają stopnie powyżej niej. Podstawa nic nie mówi o modelu; to stopnie powyżej niej robią różnicę i to one rozróżniają modele.
+1,164°
Pobrania z Civitai
6,582 pobrań tej dokładnej wersji na Civitai. Pobrania to najważniejszy składnik i liczone są na skali logarytmicznej: dziesięciokrotny wzrost pobrań dodaje te same 300°, więc model z milionem pobrań nie jest tysiąc razy gorętszy niż ten z tysiącem. Sześć źródeł pobrań dzieli ten jeden termin proporcjonalnie do ich liczby.
+414°
Polubienia
578 polubień i kciuków w górę ze wszystkich źródeł. Polubienie waży połowę pobrania, na tej samej skali logarytmicznej.
+49°
Tempo adopcji
Około 3 pobrań dziennie, mierzone między dwoma odczytami źródeł, nigdy nie szacowane na podstawie średniej z całego czasu. Prędkość waży ćwierć składnika pobrań, więc świeży wzrost jest widoczny, ale jednodniowy skok nie przebije lat użycia.
+150°
Pełny model
+150° bo to pełny model: checkpoint, same wagi. LoRA lub embedding to dodatek do czyichś wag i nie przewyższa checkpointa o tej samej popularności.
−497°
Wiek
−497° bo wagi SDXL wyszły w 2023. Każdy model dziedziczy wiek wag, na których jest zbudowany: 150° na rok, do 750°, i tak rośnie aż do tego limitu. Bez tego na szczycie listy byłyby checkpointy z 2022 i 2023, które mają lata na zbieranie pobrań.
Pokaż szczegóły
Każdą liczbę na tej stronie można sprawdzić. Wynik popularności tego modelu to 8,280°, a tutaj jest zbudowany krok po kroku, z bieżącym sumowaniem po każdym składniku: podstawa, stopnie dodawane przez każde źródło, bonus za rodzaj modelu oraz odejmowanie za wiek wag. Kolory odpowiadają zakresom na wykresie powyżej. Na końcu znajduje się słownik, który wyjaśnia każde pojęcie.
1
Zacznij od podstawy.
Dlaczego 7,000°, a nie zero: skala idzie od 0° do 9 999°, a część poniżej 7,000° jest zarezerwowana dla modeli, o których żadne źródło jeszcze nie raportuje, które mają tam zastępczą wartość, by listy były kompletne i nigdy nie wyprzedzały modeli z danymi. 7,000° to punkt startowy dla danych pomiarowych. Model z prawdziwymi danymi, ale prawie bez pobrań, stoi tutaj; wszystko co dalej to pomiary, a przestrzeń powyżej podstawy mieści dziesięć dziesięciokrotnych kroków w pobraniach po 300° każdy. Podstawa jest taka sama dla każdego modelu, więc nic nie decyduje; decydują stopnie powyżej niej.
7,000°
bieżąca suma
2
Dodaj pobrania.
6,582 równoważników pobrań łącznie, z Pobrania z Civitai. Dziesięć razy więcej pobrań dodaje ten sam 300°, więc rozmiar ma znaczenie, ale nigdy nie dominuje wyniku.
+1,164°
8,164°
bieżąca suma
3
Dodaj polubienia.
578 polubień i kciuków w górę, o połowę mniej wartości niż pobranie.
+414°
8,578°
bieżąca suma
4
Dodaj tempo adopcji.
Około 3 pobrań dziennie teraz, mierzone między dwoma odczytami, z wagą ćwierć pobrania.
+49°
8,627°
bieżąca suma
5
Bonus za pełny model.
Checkpoint zawiera same wagi; dodatki nie mają wyższej rangi niż model o takiej samej popularności.
+150°
8,777°
bieżąca suma
6
Usuń wiek.
Wagi SDXL wyszły w 2023: 150° rocznie, do maksymalnie 750°, rosnące do tego czasu.
−497°
8,280°
bieżąca suma
=
Wynik heat.
Pozycja tego modelu na każdej liście na tej stronie. Nic innego tego nie zmienia.
8,280°
Słowniczek: używane tu terminy
Wynik heat
Jedna liczba pokazująca, jak bardzo model jest używany i pożądany teraz, od 0° do 9,999°. Każda lista na tej stronie z napisem hottest jest sortowana według tego i niczego innego.
Podstawa
7,000° to punkt startowy dla każdego modelu z prawdziwymi danymi. Skala idzie od 0° do 9,999°; część poniżej podstawy jest zarezerwowana dla zastępczych modeli (bez danych), żeby model z danymi zawsze był wyżej. Podstawa jest taka sama dla wszystkich i nic nie decyduje; stopnie powyżej niej to właściwy pomiar.
Równoważniki pobrań
Wszystko, co wynik traktuje jak pobranie, zsumowane: same pobrania, każdy seeder torrenta jako 1,000, każde AI Horde zdjęcie i każde uruchomienie na stronie generującej jako jedno.
Skala logarytmiczna
Liczenie co dziesięć, nie co jeden: przejście z 1,000 do 10,000 pobrań dodaje tyle samo stopni, co z 10,000 do 100,000. Zapobiega to dominacji gigantów nad resztą.
Polubienia
Kciuki w górę i polubienia ze wszystkich źródeł, warte połowę pobrania na skali logarytmicznej.
Tempo adopcji
Ile pobrań dziennie model ma teraz, na podstawie różnicy między dwoma odczytami źródła. Ćwierć wagi terminu pobrania.
Zmierzony i szacowany
Zmierzony oznacza, że istnieją dwa odczyty źródła i różnica jest rzeczywista. Szacowany oznacza, że znana jest tylko dzisiejsza suma, a przeszłość jest rozłożona na czas życia modelu; strona mówi, który z nich pokazuje.
Seeder
Ktoś, kto trzyma kopię wag online, aby inni mogli je pobrać przez torrent, albo hostowany mirror robiący to samo. Każdy taki liczy się jako 1 000 pobrań.
AI Horde
Sieć wolontariuszy, która generuje obrazy za darmo na komputerach darczyńców. Liczba obrazów wygenerowanych z modelem jest publiczna i każde liczy się jako jedno pobranie.
Strony generujące
Strony, które mają własne kopie modelu i pozwalają ludziom generować z nim obrazy, takie jak PixAI, SeaArt i Yodayo. Ich pobrania liczą się jak na Civitai, a każde uruchomienie generowania to jedno pobranie.
Tokeny OpenRouter
Model tekstowy obsługiwany przez API, taki jak Claude czy GPT, nie ma wag do pobrania, więc jego użycie mierzy się tokenami: fragmentami tekstu, które przeczytał i napisał przez OpenRouter, bramkę używaną przez wiele aplikacji, w ciągu ostatnich 30 dni. Każde 10,000,000 tokenów liczy się jako jedno pobranie. Źródło: OpenRouter (openrouter.ai/rankings), CC BY 4.0.
Pełny model (checkpoint)
Same wagi, plik, który generuje samodzielnie. Dostaje bonus, bo dodatki od niego zależą.
LoRA i embedding
Małe pliki dodatków, które kierują czyjeś wagi w stronę stylu, postaci lub koncepcji. Nie mogą działać samodzielnie.
Rodzina i wagi
Podstawa, na której zbudowano model, np. SD 1.5, SDXL, Flux lub Wan. Każdy model dziedziczy datę wydania wag swojej rodziny.
Wiek
Stopnie odejmowane za to, jak dawno wyszły wagi rodziny: 150° za rok, do 750°. Zachowuje stare pobrania, które miały lata na narastanie, zamrażając szczyt listy.
Wzmocnienie rodziny
Małe, ograniczone wsparcie dla LoRA z rodziny, którą ta strona teraz promuje, zawsze podane w rozbiciu.
Wynik zastępczy
Stabilna liczba poniżej minimum, przyznawana modelowi, o którym jeszcze nie ma danych źródłowych, żeby listy były kompletne. Nigdy nie jest wyżej niż model z danymi.
Nowy! (okres karencji)
Model młodszy niż 7 dni pokazuje Nowy! zamiast wyniku i nie zajmuje miejsca w rankingu. Jego wynik jest liczony od pierwszego dnia, ale model jednodniowy rośnie najszybciej, więc bez oczekiwania #1 tygodnia byłby zawsze tym, który pojawił się wczoraj, a nie tym, który utrzymał się przez tydzień.
Trend
Jak wzrost modelu w danym okresie wypada na tle typowego wzrostu modelu w tym samym czasie. Szybszy niż zwykle to wzrost, wolniejszy to spadek.
Typowy model
Środek katalogu: połowa modeli z danymi rosła szybciej w tym okresie, połowa wolniej.
Jak popularność tego modelu zmieniała się w porównaniu do reszty katalogu: jego wzrost w pobraniach, polubieniach i użyciu w każdym okresie, mierzony względem typowego wzrostu modelu w tym samym czasie, wraz z jego wynikiem heat score. Powyżej typowego wzrostu oznacza wzrost, poniżej spadek. Przeszłość jest odtwarzana na podstawie dzisiejszych sum, pierwszego dnia modelu i zmierzonej prędkości pobrań, jeśli są dwa odczyty; model, który nie istniał na początku okresu, pokazuje n/d.
Przykładowe rendery
Prompty i ustawienia udostępnione przez osoby, które wykonały te rendery na Civitai. Wybierz render, aby zobaczyć, jak powstał.
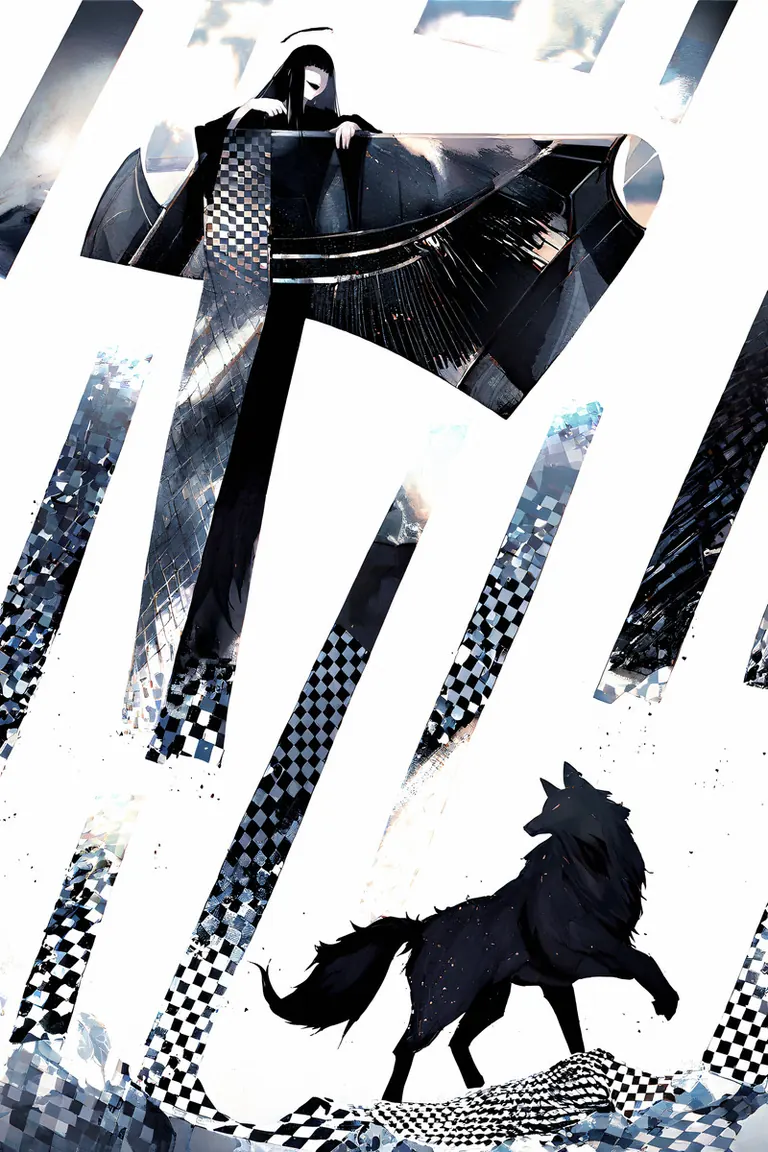
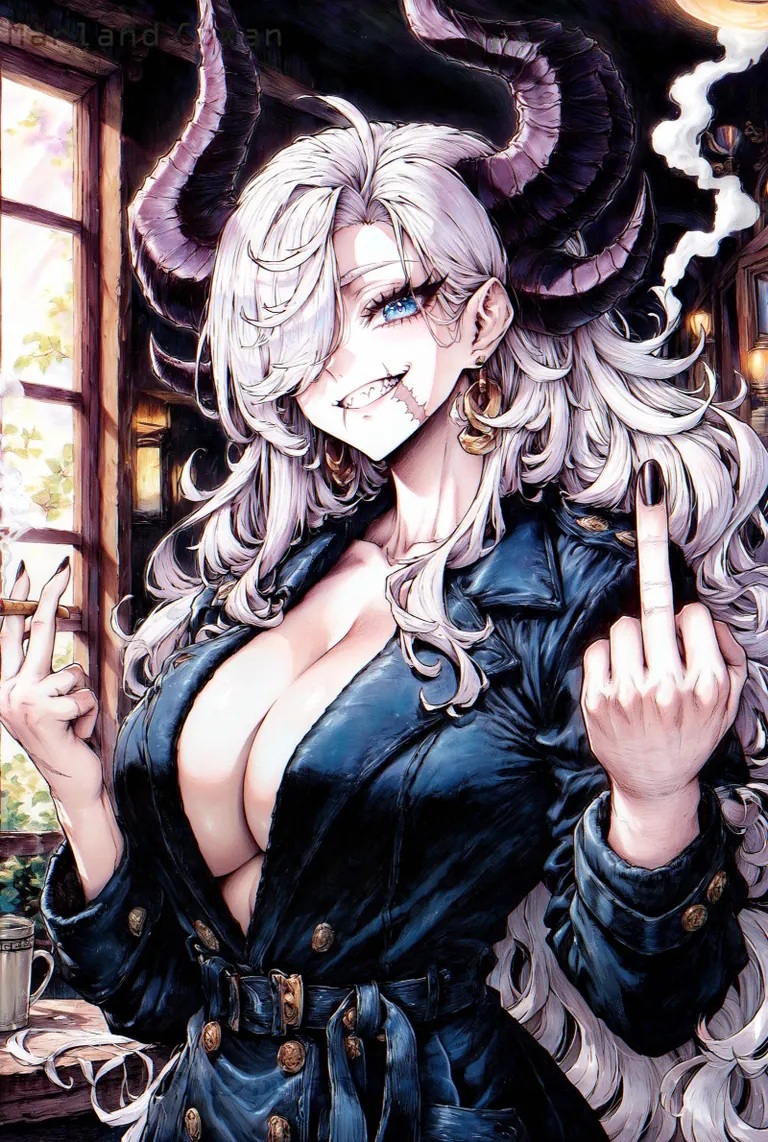
1girl, solo, angel, angel wings, white wings, blonde hair, long hair, blue eyes, large breasts, determined, closed eyes, hair over one eye, white dress, armor, red cape, sword, holding sword, standing, legs apart, wind, stormy sky, ocean, cliff, lightning, glowing eyes, halo, from side
by ranko no ane, masterpiece, best quality, BREAK,
checkered sand, 1girl, long black hair, faceless, black robe, pale skin, leaning on object, curled fingers, wide smile, evil smile,
collage, photo bashing, photoshop \(medium\), BREAK,
black wolf, giant piano, black streaks, dithering, zoom layer, halo,
MiMo-V2.6-Pro to flagowy model Xiaomi: rzadki system Mixture-of-Experts z 1,02 biliona parametrów łącznie (42 miliardy aktywnych), obsługujący tekst, obraz, wideo i audio w jednym modelu. Jego cechą wyróżniającą jest pipeline uczenia ze wzmocnieniem zaprojektowany do ciągłego samodoskonalenia przez eksplorację, zamiast osobnego dostrajania dla każdej dziedziny. Pasuje do zespołów realizujących złożone agentowe workflowy, zadania z długim kontekstem lub badania oraz dla każdego, kto chce mieć zdolny model frontierowy z otwartymi wagami w cenie poniżej dolara za milion tokenów.
Znany z
Prawdziwie omnimodalny: tekst, obraz, wideo i audio obsługiwane natywnie w jednym modelu
Okno kontekstu na 1 milion tokenów — wystarczająco długie na całe repozytoria lub wielosesyjne agentowe zadania
Pojedynczy mieszany przebieg RL obejmujący zadania kodowania, wizualne, ogólne i cyberbezpieczeństwa
Poważny model frontierowy z otwartymi wagami do pracy agentowej i z długim kontekstem — cena jest rozsądna, ale wymagania sprzętowe nie są trywialne.Wyrok kapitana