Stile > gpt-image-2 per Anima: miglioratore di dettagli, illuminazione e texture
Argomento: Modelli

Di Captain
Pubblicato il 2026-10-01
Render di esempio
Prompt e impostazioni condivisi da chi ha realizzato questi render su Civitai. Scegli un render per vedere come è stato fatto.
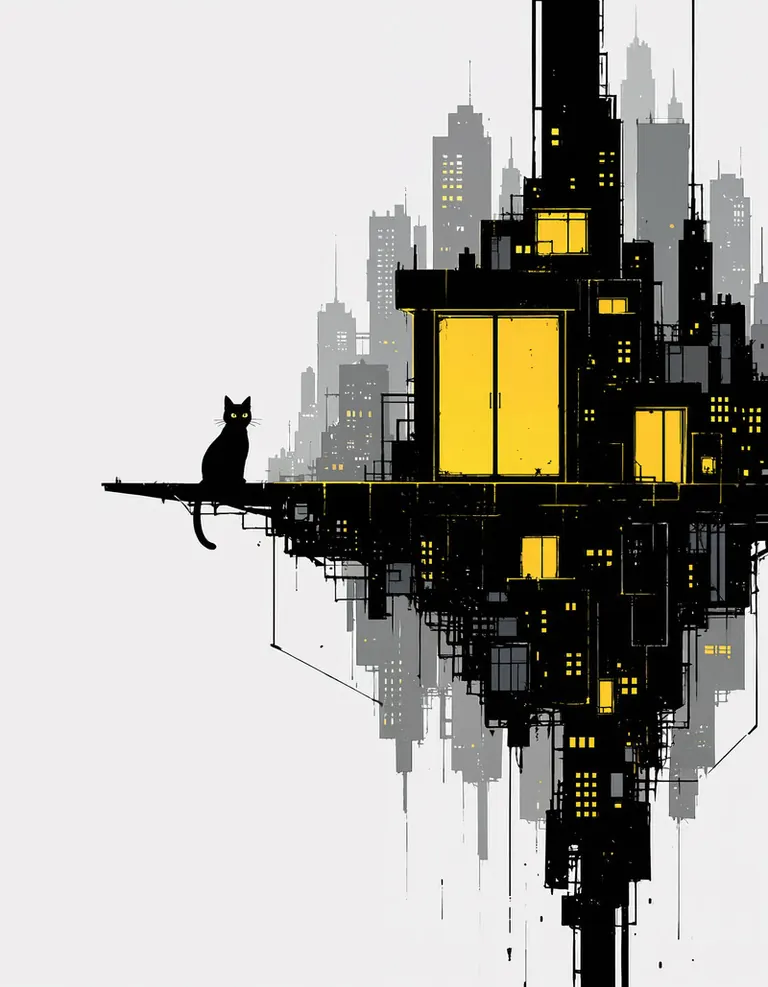
Impostazioni
Sampler
dpmpp_2m_sde_gpu
Passi
26
Guidance
4
Seed
625092882408448
Dimensioni
1792x2304
Prompt
masterpiece, best quality, score_7, @gpt-image-2,
conceptual illustration, a tiny black cat sitting on a sharp ledge, background is a massive geometric abstraction of a city skyline constructed from flat intersecting grey and black rectangular blocks, a single glowing neon yellow window block stands out as a vibrant spot color, flat graphic design style, stark negative space, high contrast
Prompt negativo
worst quality, low quality, score_1, score_2, score_3, artist name, blurry, jpeg artifacts, lowres, censor, fused hand,
Il LoRA di AgileNumbers guida Anima verso l'aspetto di gpt-image-2: più dettagli, illuminazione e texture. Scopri il trigger @gpt-image-2, le differenze tra v1 e v1.1, consigli sulla forza e idee.
Panoramica
Lo Stile > gpt-image-2 (Anima-base1 v1.1) di AgileNumbers indirizza
Anima
verso lo stile di gpt-image-2. Migliora molto dettagli, illuminazione e texture, ma può dare un aspetto un po' trasandato, quindi l'autore lo usa come un potenziatore da applicare con forza variabile.
La v1.1 aggiunge più texture e dettaglio, cambia meno i colori e influenza meno la posa rispetto alla v1, ma resta più fedele ai volti di gpt-image-2 e presenta qualche texture ripetuta; la v1 dà colori più vivaci con meno texture. È stato addestrato senza un set di regolarizzazione, quindi il trigger @gpt-image-2 è opzionale ma aiuta un po'.
Riferimento
Nome | Tipo | Cos'è |
|---|---|---|
Trigger | @gpt-image-2 | Opzionale. |
LoRA weight | 0.4-0.9 | Varia per diversità di stile. |
Version | v1 / v1.1 | Texture o colore. |
Base | Anima base 1 | |
Prompt | conceptual | Le illustrazioni concettuali lo mostrano bene. |
AD

Nessuna installazione: esegui i modelli IA nel cloud
BitVector Prism è il modo più semplice per iniziare: scegli un modello, scrivi un prompt e genera in una web app pulita, senza configurare nulla. BitVector è disponibile anche su Discord e sul web (SpyGlass).
Passo dopo passo
- Tag di qualità, @gpt-image-2, poi un prompt per illustrazione concettuale.
- Peso 0.6.
- Confronta con 0.9 per texture completa.
- Passa a v1 per colori più vivaci.
Esempi
Concettuale
masterpiece, best quality, score_7, @gpt-image-2, conceptual illustration, a tiny black cat sitting on a sharp ledge, a massive geometric abstraction of a city skyline made of flat intersecting grey planes behind it
gpt-image-2 style 0.7
Editoriale
masterpiece, best quality, @gpt-image-2, editorial illustration, an adult reading on a giant stack of books, soft directional light, textured paper
Idea creativa: set di icone
masterpiece, best quality, @gpt-image-2, a set of six weather icons, soft 3D lighting, cream background
Consigli
- Va bene con prompt di astrazione geometrica e design grafico.
- Pesi più bassi mantengono i volti originali di Anima.
- La ripetizione di texture si vede su grandi aree piatte; aggiungi dettagli lì.
- Adatto per illustrazioni in stile editoriale.
Risoluzione dei problemi
I volti sembrano tutti uguali
Perché succede
v1.1 con peso alto.
Come risolverlo
0.5 o v1.
Texture ripetuta
Perché succede
v1.1 su aree piatte.
Come risolverlo
Aggiungi parole di dettaglio o abbassa il peso.
AD

Nessuna installazione: esegui i modelli IA nel cloud
PirateDiffusion è solo su Telegram ed è pensato per i professionisti: migliaia di modelli, LoRA e workflow tramite comandi in chat, con generazione illimitata a prezzo fisso.

Domande
Trigger necessario?
Opzionale.
Quale versione?
v1.1 per texture, v1 per colore.
Link e fonti
Modelli di questa guida
Scritto da
Captain
Guide correlate
Modelli
Anime in Real per Anima: personaggi anime in sfondi realistici
Lo LoRA Anime in Real di Zoropaton mette i personaggi anime di Anima in ambienti fotorealistici. Scopri il trigger @Ani3rel, i tag solo, profondità di campo e sfondo sfocato che ama, e idee creative.
Di Captain
2026-09-30
Modelli
Modificatori di Qualità Estetica - Masterpiece per Anima: dare valore ai tag di qualità
Il Masterpiece LoRA di motimalu per Anima è stato addestrato solo su immagini valutate a mano come masterpiece, quindi i tag di qualità all'inizio del tuo prompt hanno davvero effetto. Impara la struttura del prompt, il peso e come combinarlo con i tag degli artisti.
Di Captain
2026-10-01
Altre guide

Modelli
FLUX.1 Dev: come usarlo, impostazioni migliori e idee creative
Una guida pratica a FLUX.1 Dev di Black Forest Labs: come scrivere i prompt in linguaggio naturale, impostazioni di guida e passi, stacking di LoRA, rendering del testo e idee per prompt che sfruttano i suoi punti di forza.
Di Captain
2026-09-30

Modelli
Stable Diffusion XL 1.0: prompt, impostazioni e cosa fa ancora meglio
Come ottenere il massimo dal modello base ufficiale SDXL 1.0: risoluzioni native, impostazioni di CFG e sampler, il refiner, prompt negativi e idee per stili in cui SDXL brilla ancora.
Di Captain
2026-10-01

Modelli
Stable Diffusion 1.5: il modello classico, usato nel modo giusto
Stable Diffusion 1.5 vale ancora la pena conoscerlo: la risoluzione giusta, CFG e sampler, come usare la sua enorme libreria di LoRA e embedding, e idee creative per prompt adatte a un modello a 512 pixel.
Di Captain
2026-10-02

Modelli
FLUX.2 Dev: come usare il modello più recente di Black Forest Labs
FLUX.2 Dev supporta prompt più lunghi, testo migliore, realismo più forte e modifica con riferimenti multipli. Questa guida spiega il flusso turbo, le impostazioni di guida e risoluzione, la struttura del prompt e idee che sfruttano le sue nuove potenzialità.
Di Captain
2026-10-03

Modelli
Qwen-Image: prompt lunghi, testo perfetto e poster bilingue
Qwen-Image è il modello da usare quando le parole nell'immagine contano. Scopri come scrivere prompt descrittivi lunghi, riprodurre testo in inglese e cinese con precisione, impostare CFG e passi, e esplorare idee creative con layout complessi.
Di Captain
2026-09-29

Modelli
SDXL-Lightning: generazione in quattro passaggi su qualsiasi checkpoint SDXL
Lo LoRA SDXL-Lightning di ByteDance trasforma un rendering SDXL da 30 passaggi in uno da 4. Scopri il numero di passaggi, il CFG da usare, il sampler e come combinarlo con i tuoi checkpoint e LoRA di stile preferiti.
Di Captain
2026-09-30

Model
Trends
.ai
© ModelTrends.ai
|
Fatto in Giappone
|
© 2026