
Animagine XL V3.1
8741°
<animagine3-xl>
Apps que suportam as tags do ModelTrends permitem que você execute/instale modelos copiando este código no seu prompt, sem precisar configurar nada. Procure nosso ícone em apps que suportam, como o Prism (abaixo).
Executar modelo
Ofertas / Anúncios

Easy Creator (Prism) Web
Ilimitado · taxa fixa
Melhor para iniciantes. Fluxos de trabalho poderosos, curva de aprendizado baixa.

PirateDiffusion Telegram
Ilimitado · taxa fixa
Crie vídeos, imagens, personas de chat personalizadas e muito mais.

Pro studio (SpyGlass) Web
Ilimitado · taxa fixa
Navegue por modelos, renderize e refine de qualquer navegador ou celular.

Discord bot (Vector)
Ilimitado · taxa fixa
Adicione o Vector ao seu servidor ou entre no Discord do Vector. Crie qualquer coisa!

Unified Editor Web
Ilimitado · taxa fixa
Editor para imagens e vídeos: renderize, edite, aumente a resolução e mais em uma única página.

Civitai Web
Pague por uso
Gere no site do Civitai; cada imagem é paga com créditos Buzz.

Apps locais Local
Requer configuração
Instale programas locais se seu computador tiver hardware compatível.

ModelDuel Web
Pague por uso
Gere o mesmo prompt em até 50 modelos checkpoint/base ao mesmo tempo.

Notas do criador
Animagine XL 3.1 is an update in the Animagine XL V3 series, enhancing the previous version, Animagine XL 3.0. This open-source, anime-themed text-to-image model has been improved for generating anime-style images with higher quality. It includes a broader range of characters from well-known anime series, an optimized dataset, and new aesthetic tags for better image creation. Built on Stable Diffusion XL, Animagine XL 3.1 aims to be a valuable resource for anime fans, artists, and content creators by producing accurate and detailed representations of anime characters.
Model Details
-
Developed by:
-
In collaboration with:
-
Model type: Diffusion-based text-to-image generative model
-
Model Description: Animagine XL 3.1 generates high-quality anime images from textual prompts. It boasts enhanced hand anatomy, improved concept understanding, and advanced prompt interpretation.
-
License:
-
Fine-tuned from:
Usage Guidelines
Tag Ordering
For optimal results, it's recommended to follow the structured prompt template because we train the model like this:
1girl/1boy, character name, from what series, everything else in any order.
Special Tags
Animagine XL 3.1 utilizes special tags to steer the result toward quality, rating, creation date and aesthetic. While the model can generate images without these tags, using them can help achieve better results.
Quality Modifiers
Quality tags now consider both scores and post ratings to ensure a balanced quality distribution. We've refined labels for greater clarity, such as changing 'high quality' to 'great quality'.
Quality Modifier Score Criterion
masterpiece > 95%
best quality > 85% & ≤ 95%
great quality > 75% & ≤ 85%
good quality > 50% & ≤ 75%
normal quality > 25% & ≤ 50%
low quality > 10% & ≤ 25%
worst quality ≤ 10%
Rating Modifiers
We've also streamlined our rating tags for simplicity and clarity, aiming to establish global rules that can be applied across different models. For example, the tag 'rating: general' is now simply 'general', and 'rating: sensitive' has been condensed to 'sensitive'.
Rating Modifier Rating Criterion
safe General
sensitive Sensitive
nsfw Questionable
explicit, nsfw Explicit
Year Modifier
We've also redefined the year range to steer results towards specific modern or vintage anime art styles more accurately. This update simplifies the range, focusing on relevance to current and past eras.
Year Tag Year Range
newest 2021 to 2024
recent 2018 to 2020
mid 2015 to 2017
early 2011 to 2014
oldest 2005 to 2010
Aesthetic Tags
We've enhanced our tagging system with aesthetic tags to refine content categorization based on visual appeal. These tags are derived from evaluations made by a specialized ViT (Vision Transformer) image classification model, specifically trained on anime data. For this purpose, we utilized the model , which assesses the aesthetic value of content before it undergoes training. This ensures that each piece of content is not only relevant and accurate but also visually appealing.
Aesthetic Tag Score Range
very aesthetic > 0.71
aesthetic > 0.45 & 0.27 & < 0.45
very displeasing ≤ 0.27
Recommended settings
To guide the model towards generating high-aesthetic images, use negative prompts like:
nsfw, lowres, (bad), text, error, fewer, extra, missing, worst quality, jpeg artifacts, low quality, watermark, unfinished, displeasing, oldest, early, chromatic aberration, signature, extra digits, artistic error, username, scan, [abstract]
For higher quality outcomes, prepend prompts with:
masterpiece, best quality, very aesthetic, absurdres
it’s recommended to use a lower classifier-free guidance (CFG Scale) of around 5-7, sampling steps below 30, and to use Euler Ancestral (Euler a) as a sampler.
Multi Aspect Resolution
This model supports generating images at the following dimensions:
Dimensions Aspect Ratio
1024 x 1024 1:1 Square
1152 x 896 9:7
896 x 1152 7:9
1216 x 832 19:13
832 x 1216 13:19
1344 x 768 7:4 Horizontal
768 x 1344 4:7 Vertical
1536 x 640 12:5 Horizontal
640 x 1536 5:12 Vertical
Acknowledgements
The development and release of Animagine XL 3.1 would not have been possible without the invaluable contributions and support from the following individuals and organizations:
-
: Our collaboration partner and sponsor.
-
: For providing the aesthetic classification model, .
-
: For their custom learning rate scheduler, adapted from .
-
: For their comprehensive training scripts.
-
Cagliostrolab Collaborators: For their dedication to model training, project management, and data curation.
-
Early Testers: For their valuable feedback and quality assurance efforts.
-
NovelAI: For their innovative approach to aesthetic tagging, which served as an inspiration for our implementation.
Thank you all for your support and expertise in pushing the boundaries of anime-style image generation.
Limitations
While Animagine XL 3.1 represents a significant advancement in anime-style image generation, it is important to acknowledge its limitations:
-
Anime-Focused: This model is specifically designed for generating anime-style images and is not suitable for creating realistic photos.
-
Prompt Complexity: This model may not be suitable for users who expect high-quality results from short or simple prompts. The training focus was on concept understanding rather than aesthetic refinement, which may require more detailed and specific prompts to achieve the desired output.
-
Prompt Format: Animagine XL 3.1 is optimized for Danbooru-style tags rather than natural language prompts. For best results, users are encouraged to format their prompts using the appropriate tags and syntax.
-
Anatomy and Hand Rendering: Despite the improvements made in anatomy and hand rendering, there may still be instances where the model produces suboptimal results in these areas.
-
Dataset Size: The dataset used for training Animagine XL 3.1 consists of approximately 870,000 images. When combined with the previous
SHA256
1449E5B0B9DE87B0F414C5F29CB11CE3B3DC61FA2B320E784C9441720BF7B766
Tendência de popularidade de Animagine XL V3.1
Pontuação de calor, últimos 12 meses
Pontuação de destaque
8,741°
Esta semana
▼
0.6%
8,744° então, 8,741° agora
Este mês
▼
2.4%
8,753° então, 8,741° agora
Último ano
▼
29.0%
8,888° então, 8,741° agora
7,000°
Piso
A escala vai de 0° a 9.999°. Tudo abaixo de 7,000° é reservado para modelos que nenhuma fonte reportou ainda, que carregam um número provisório ali para as listas ficarem completas. 7,000° é onde começam os dados medidos: um modelo com dados reais mas quase nenhum download fica no piso, e as medições preenchem os graus acima dele. O piso não diz nada sobre o modelo; só os graus acima dele dizem, e são eles que diferenciam um modelo do outro.
+1,516°
Downloads no Civitai
98,246 downloads desta versão exata no Civitai. Downloads são o ingrediente mais pesado e são contados numa escala logarítmica: dez vezes os downloads adicionam os mesmos 300°, então um modelo com um milhão de downloads não é mil vezes mais quente que um com mil. As seis fontes de downloads compartilham esse termo, dividido entre elas proporcionalmente aos seus contadores.
+523°
Curtidas
3,048 curtidas e thumbs up nas fontes. Uma curtida vale metade de um download, na mesma escala logarítmica.
+49°
Taxa de adoção
Cerca de 3 downloads por dia, medidos entre duas leituras das fontes, nunca estimados por média de vida útil. A velocidade pesa um quarto do termo de downloads, então um surto recente aparece sem deixar um pico de um dia superar anos de uso.
+150°
Modelo completo
+150° porque este é um modelo completo: um checkpoint, os próprios pesos. Um LoRA ou embedding é um complemento aos pesos de outra pessoa e não supera um checkpoint com a mesma popularidade.
−497°
Idade
−497° porque os pesos da família SDXL saíram em 2023. Todo modelo herda a idade dos pesos em que foi construído: 150° por ano, até 750°, e continua crescendo até lá. Sem isso, o topo da lista seria só checkpoints de 2022 e 2023 baseados em downloads que tiveram anos para acumular.
Mostrar detalhamento
Cada número neste site pode ser verificado. A pontuação de popularidade deste modelo é 8,741°, e aqui ela é construída um ingrediente de cada vez, com o total acumulado após cada um: o piso, os graus que cada fonte adiciona, o bônus pelo tipo de modelo e o que a idade dos pesos subtrai. As cores são as faixas do gráfico acima. O glossário no final define cada termo.
- 1Comece pelo piso.Por que 7,000° e não zero: a escala vai de 0° a 9.999°, e a parte abaixo de 7,000° é reservada para modelos que nenhuma fonte reportou ainda, que carregam um número provisório ali para as listas ficarem completas e nunca ficarem acima de um modelo com dados. 7,000° é onde começam os dados medidos. Um modelo com dados reais mas quase nenhum download fica aqui; tudo que vem depois é medição, e o espaço acima do piso tem dez passos de dez vezes mais downloads, com 300° cada. O piso é o mesmo para todo modelo, então ele não decide nada; os graus acima dele é que decidem.7,000°total acumulado
- 2Some as downloads.98,246 equivalentes a downloads no total, de Downloads no Civitai. Dez vezes os downloads adicionam o mesmo 300°, então o tamanho importa, mas nunca domina a pontuação.+1,516°8,516°total acumulado
- 3Some os likes.3,048 likes e joinhas, valendo metade de um download.+523°9,039°total acumulado
- 4Adicione a taxa de adoção.Cerca de 3 downloads por dia agora, medido entre duas leituras, valendo um quarto do peso.+49°9,088°total acumulado
- 5Bônus para um modelo completo.Um checkpoint carrega os pesos em si; complementos não superam um modelo com a mesma popularidade.+150°9,238°total acumulado
- 6Remova a idade.Os pesos SDXL saíram em 2023: 150° por ano, até 750°, crescendo até lá.−497°8,741°total acumulado
- =A pontuação heat.Onde este modelo está em todas as listas deste site. Nada mais altera isso.8,741°
Glossário: os termos usados aqui
- Pontuação heat
- Um número que mostra o quanto um modelo está sendo usado e desejado agora, de 0° a 9.999°. Toda lista neste site que diz mais quente é ordenada por ele e só por ele.
- Limite mínimo
- Os 7.000° que todo modelo com dados reais começa. A escala vai de 0° a 9.999°; a parte abaixo do limite é para substitutos (modelos sem dados), para que um modelo com dados sempre fique acima de um sem. O limite é igual para todos e não decide nada; os graus acima dele são a medida.
- Equivalentes a downloads
- Tudo que a pontuação trata como download, somado: downloads em si, cada torrent seeder como 1.000, cada imagem AI Horde e cada execução em site de geração como um.
- Escala logarítmica
- Contando de dez em dez, não de um em um: ir de 1.000 para 10.000 downloads adiciona os mesmos graus que ir de 10.000 para 100.000. Isso evita que gigantes abafem tudo.
- Likes
- Joinhas e likes de todas as fontes, valendo metade de um download na escala logarítmica.
- Taxa de adoção
- Quantos downloads por dia um modelo recebe agora, pela diferença entre duas leituras de uma fonte. Um quarto do peso do termo download.
- Medido e estimado
- Medido significa que existem duas leituras de uma fonte e a diferença é real. Estimado significa que só se sabe o total de hoje e o passado é distribuído ao longo da vida do modelo; o site indica qual está mostrando.
- Seeder
- Alguém que mantém uma cópia dos pesos online para outros baixarem via torrent, ou um espelho hospedado fazendo o mesmo. Cada um conta como 1.000 downloads.
- AI Horde
- Uma rede voluntária que gera imagens de graça em computadores doados. O número de imagens feitas com um modelo é público, e cada uma conta como um download.
- Sites de geração
- Sites que hospedam suas próprias cópias de um modelo e deixam as pessoas gerarem com ele, como PixAI, SeaArt e Yodayo. Os downloads deles contam como os do Civitai e cada geração conta como um download.
- Tokens OpenRouter
- Um modelo de texto servido via API, como Claude ou GPT, não tem pesos para baixar, então seu uso é medido em tokens: os pedaços de texto que ele leu e escreveu via OpenRouter, um gateway usado por muitos apps, nos últimos 30 dias. Cada 10,000,000 tokens contam como um download. Fonte: OpenRouter (openrouter.ai/rankings), CC BY 4.0.
- Modelo completo (checkpoint)
- Os pesos em si, o arquivo que gera sozinho. Ganha um bônus porque complementos dependem dele.
- LoRA e embedding
- Arquivos pequenos que direcionam os pesos de outra pessoa para um estilo, personagem ou conceito. Não podem rodar sozinhos.
- Família e pesos
- A base em que um modelo é construído, como SD 1.5, SDXL, Flux ou Wan. Todo modelo herda a data de lançamento dos pesos da sua família.
- Idade
- Pontos retirados conforme há quanto tempo os pesos da família foram lançados: 150° por ano, até 750°. Mantém os downloads antigos que tiveram anos para acumular, evitando que saiam do topo da lista.
- Impulso da família
- Um pequeno empurrão limitado para LoRAs de uma família que este site está promovendo agora, sempre listado na divisão.
- Pontuação provisória
- Um número estável abaixo do mínimo dado a um modelo que ainda não tem dados de fonte, para a lista ficar completa. Nunca fica acima de um modelo com dados.
- Novo! (período de carência)
- Um modelo com menos de 7 dias mostra Novo! em vez de uma pontuação e não ocupa lugar no ranking. Sua pontuação é calculada desde o primeiro dia, mas um modelo com um dia cresce mais rápido que qualquer outro, então sem a espera o #1 da semana seria sempre o que saiu ontem, não o que se manteve por uma semana.
- Tendência
- Como o crescimento de um modelo num período se compara com o crescimento típico dos modelos no mesmo período. Crescimento mais rápido que o típico indica alta, mais lento indica queda.
- Modelo típico
- O meio do catálogo: metade dos modelos com número cresceu mais rápido no período, metade mais devagar.
Como a popularidade deste modelo mudou em relação ao resto do catálogo: seu crescimento em downloads, curtidas e uso em cada período, medido contra o crescimento típico dos modelos no mesmo período, junto com sua pontuação de calor na época. Acima do crescimento típico significa alta, abaixo significa queda. O passado é reconstruído a partir dos totais de hoje, do primeiro dia do modelo e da velocidade de download medida quando existem duas leituras; um modelo que não existia no começo do período mostra n/a.
Renders de exemplo
Prompts e configurações compartilhados por quem fez estes renders no Civitai. Escolha um render para ver como foi feito.
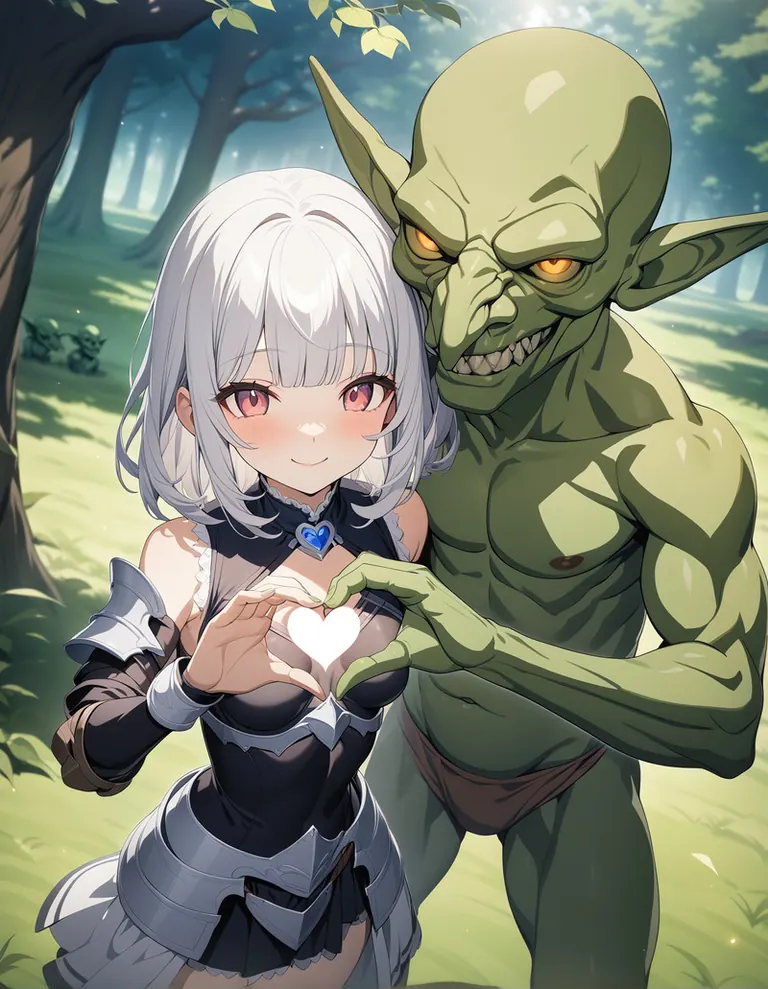
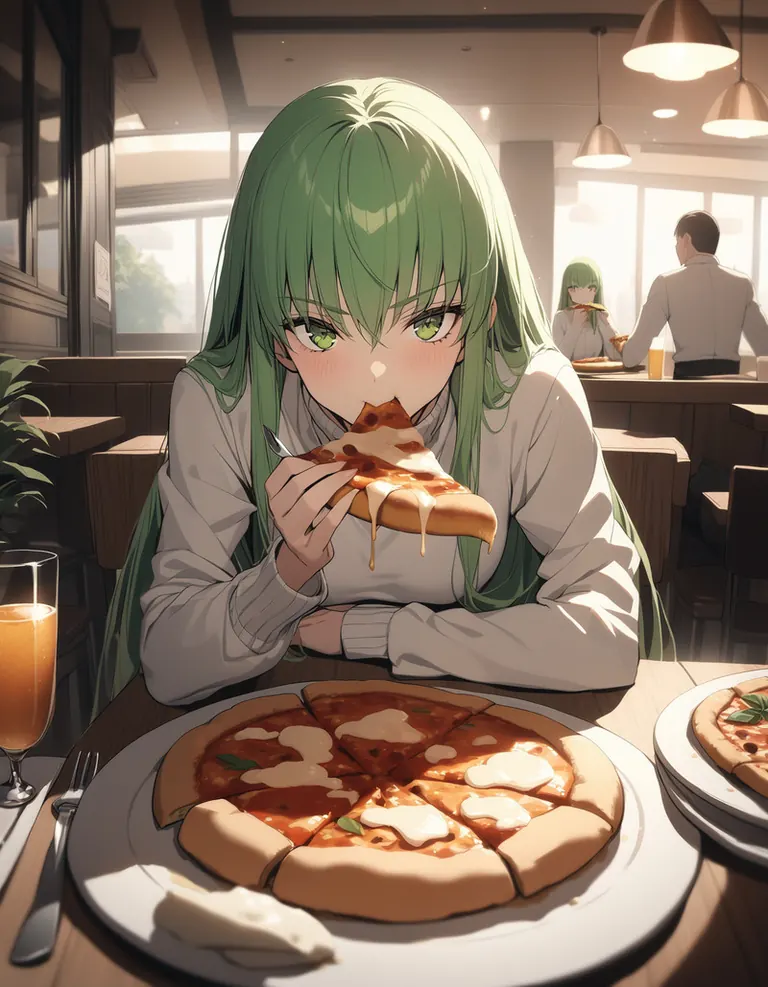
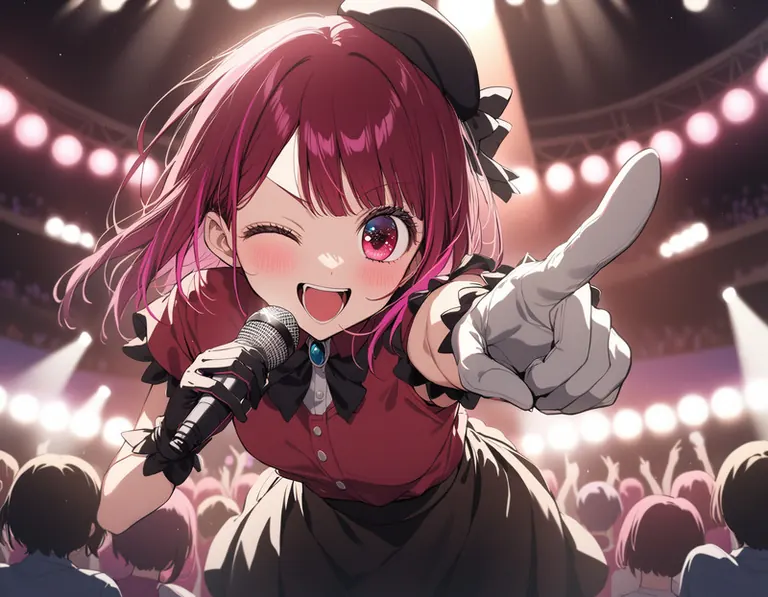
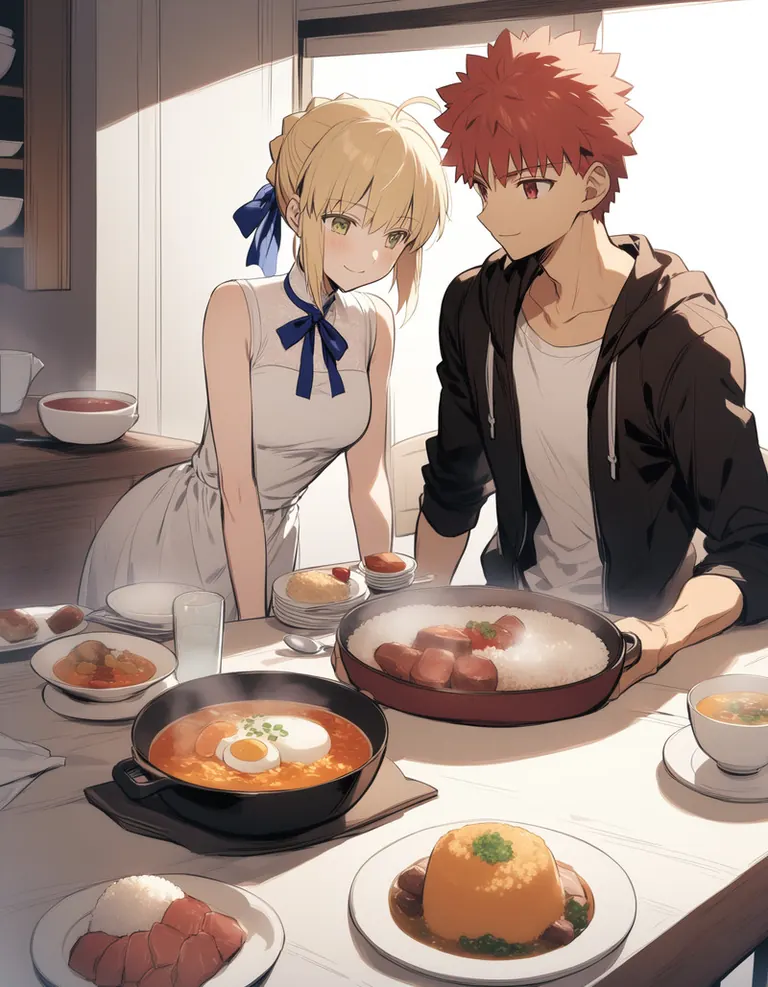
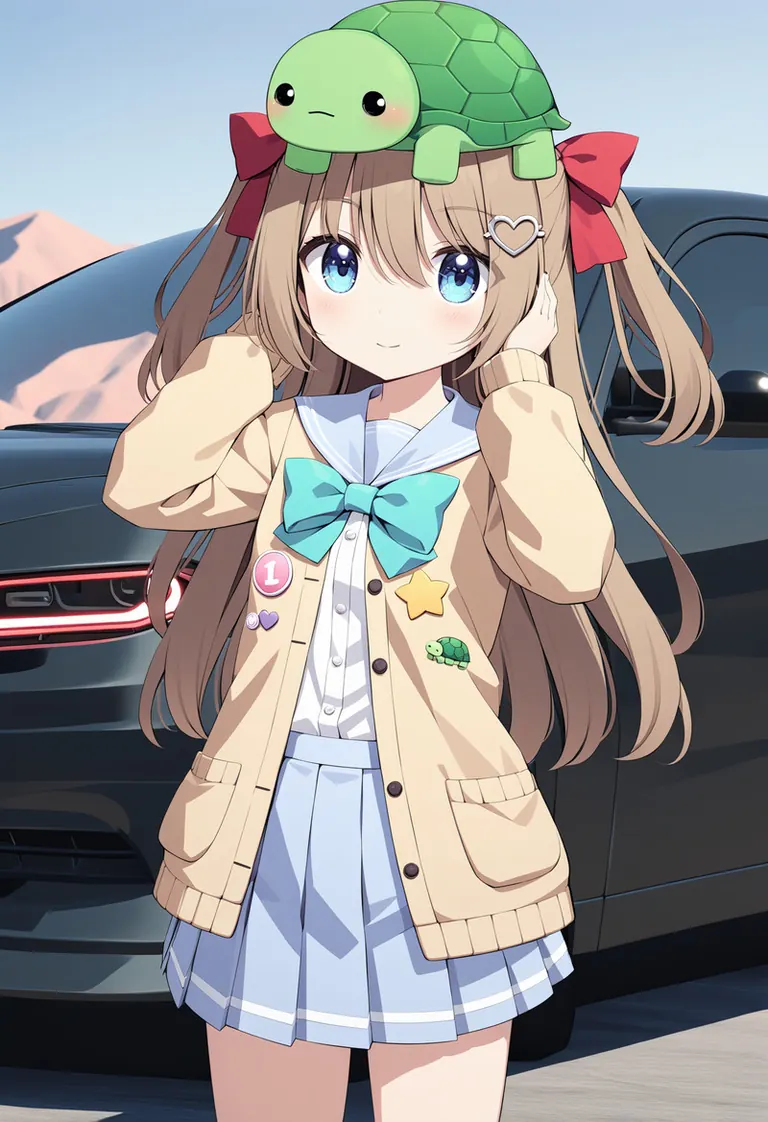
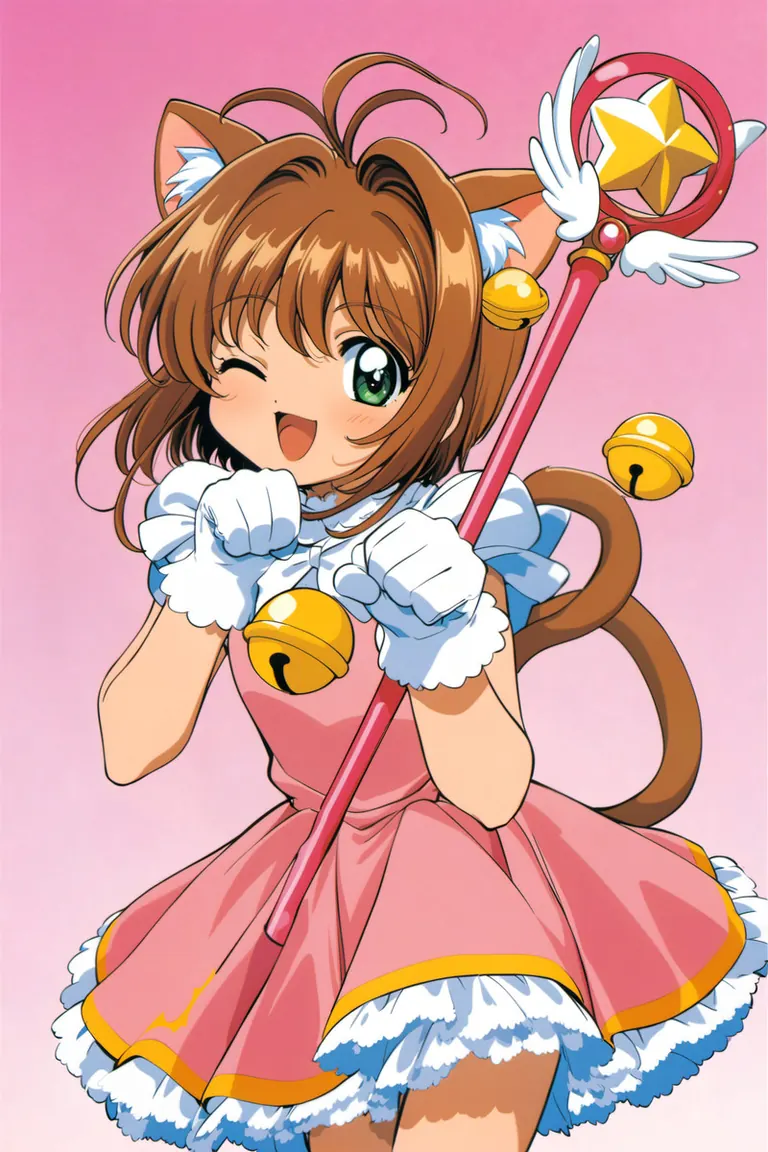
Configurações
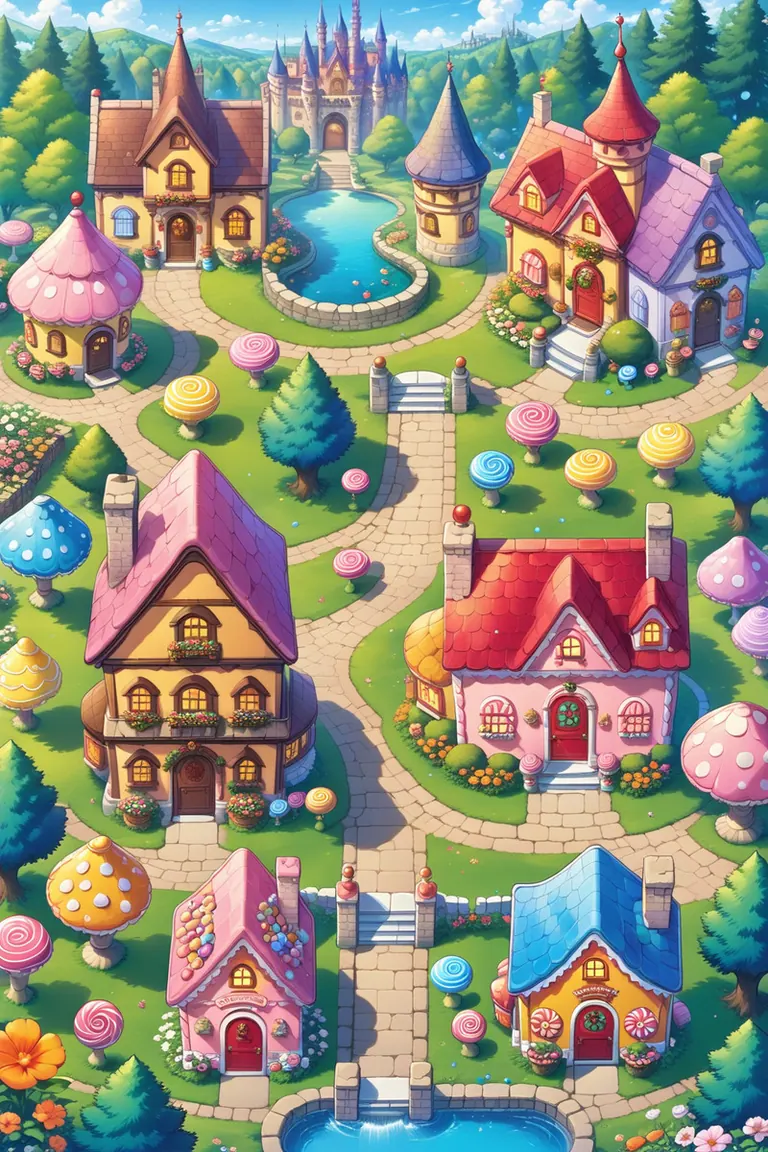
Sampler
Euler a
Passos
30
Guidance
7
Seed
1422384220
Tamanho
1024x1536
Clip skip
2
Prompt
flower, outdoors, day, water, tree, no humans, window, grass, plant, building, scenery, stairs, yellow flower, fence, door, potted plant, bush, house, orange flower, pond, garden, chimney, HD, best quality, 16k,Masterpiece, simple, neat, castle, candy house, forest, mushroom, fruit, flower, fairy tale world, <lora:lora:0.8>
Prompt negativo
windows,canvas frame,cartoon,3d,((disfigured)),((bad art)),((deformed)),((extra limbs)),((close up)),((b&w)),wierd colors,blurry,(((duplicate))),((morbid)),((mutilated)),[out of frame],extra fingers,mutated hands,((poorly drawn hands)),((poorly drawn face)),(((mutation))),(((deformed))),blurry,((bad anatomy)),(((bad proportions))),((extra limbs)),cloned face,(((disfigured))),out of frame,extra limbs,(bad anatomy),gross proportions,(malformed limbs),((missing arms)),((missing legs)),(((extra arms))),(((extra legs))),mutated hands,(fused fingers),(too many fingers),(((long neck))),Photoshop,video game,tiling,poorly drawn hands,poorly drawn feet,poorly drawn face,out of frame,mutation,mutated,extra limbs,extra legs,extra arms,disfigured,deformed,cross-eye,body out of frame,blurry,bad art,bad anatomy,3d render,((naked)),((nude)),((NSFW)),(((claws))),
Configurações
Sampler
Euler a
Passos
28
Guidance
7
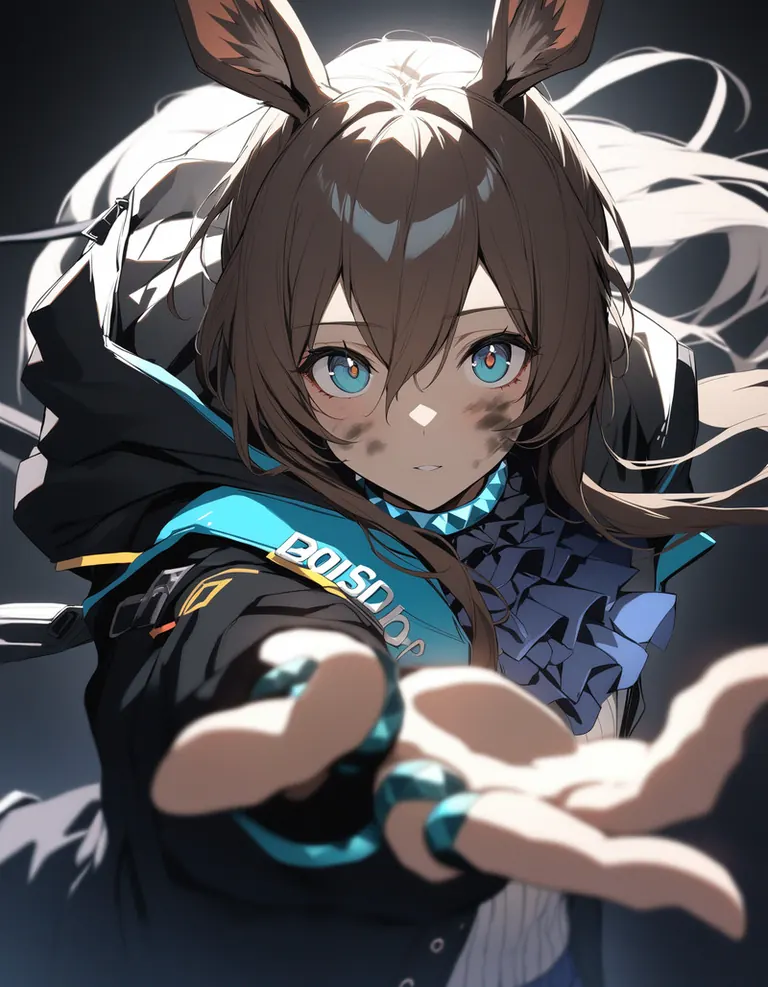
Tamanho
1344x1728
Prompt
1girl, amiya \(arknights\), arknights, dirty face, outstretched hand, close-up, cinematic angle, foreshortening, dark, dark background, masterpiece, best quality
Prompt negativo
nsfw, lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry, artist name,
Configurações
Sampler
Euler a
Passos
33
Guidance
7
Seed
1744234110
Tamanho
896x1152
Clip skip
2
Prompt
white hair, medium hair, blunt bangs, small breasts, 1girl, armored dress, shoulder armor, hetero, heart hands duo, smile, happy, cowboy shot, looking at viewer, standing, <lora:GoblinXL_LoRA-C3Lier_AdamW_Dim4_Alpha4_5e-5_4batch_CosineAnnealingLR_animagineXLV3_v30Base:1>, 1boy, goblin, waistcoat, grass, forest, tree shade, lens flare, game cg, masterpiece, best quality, highres, newest, late
Prompt negativo
lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry, artist name
Configurações
Sampler
Euler a
Passos
28
Guidance
7
Tamanho
1344x1728
Prompt
1girl, c.c., code geass, white shirt, long sleeves, turtleneck, sitting, looking at viewer, eating, pizza, plate, fork, knife, table, chair, table, restaurant, cinematic angle, cinematic lighting, masterpiece, best quality
Prompt negativo
nsfw, lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry, artist name,
Configurações
Sampler
Euler a
Passos
28
Guidance
7
Seed
1966975782
Tamanho
1728x1344
Prompt
1girl, arima kana, oshi no ko, solo, idol, idol clothes, one eye closed, red shirt, black skirt, black headwear, gloves, stage light, singing, open mouth, crowd, smile, pointing at viewer, masterpiece, best quality
Prompt negativo
nsfw, lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry, artist name,
Configurações
Sampler
Euler a
Passos
28
Guidance
7
Tamanho
1344x1728
Prompt
A boy and a girl, Emiya Shirou and Artoria Pendragon from fate series, having their breakfast in the dining room. Emiya Shirou wears white t-shirt and jacket. Artoria Pendragon wears white dress with blue neck ribbon. Rice, soup, and minced meats are served on the table. They look at each other while smiling happily, masterpiece, best quality
Prompt negativo
nsfw, lowres, bad anatomy, bad hands, text, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, signature, watermark, username, blurry, artist name,
Configurações
Sampler
Euler a
Passos
36
Guidance
7
Seed
1776325172
Tamanho
832x1216
Clip skip
2
Prompt
1girl, neuro-sama, (yuzu modoki:1.22), on head, animal on head, cowboy shot, blue eyes, aqua bow, yellow cardigan, open cardigan, blue sailor collar, blue skirt, pleated skirt, turtle, heart, button badge, star \(symbol\), drone, the number "1" on a badge, red ribbon, hair ribbon, two side up, heart hair ornament, long sleeves, light brown hair, natural lighting, (masterpiece, best quality), detailed scenery, (3d render:0.7), background 2020 dodge charger four door, highly detailed, finely detailed <lora:neurosama_animaginexl_3-15:0.7>
Prompt negativo
unaestheticXLv31, lowres, bad anatomy, bad hands, error, missing fingers, extra digit, fewer digits, cropped, worst quality, low quality, normal quality, jpeg artifacts, blurry, black background, dark background, nsfw, rating:questionable, rating:explicit
Configurações
Sampler
DPM++ 2M Karras
Passos
40
Guidance
6
Seed
2065776456
Tamanho
960x1440
Clip skip
2
Prompt
1girl, kinomoto sakura, animal ears, one eye closed, cat ears, solo, tail, brown hair, bell, green eyescat tail, magical girl, dress, paw pose, short hair, smile, open mouth, 1990s (style), retro artstyle, ;d, jingle bell, wand, looking at viewer, pink dress, antenna hair,<lora:Card Captor Sakura Anime_XL:0.8>
Prompt negativo
negativeXL_D, sketch, duplicate, ugly, (huge eyes:1.2), text, logo, monochrome, (worst face:1.5), (bad and mutated hands:1.3), (worst quality:2.0), (low quality:2.0), (blurry:2.0), horror, geometry, bad prompt, (bad hands:1.2), (missing fingers:1.2), (multiple limbs:1.2), bad anatomy, (interlocked fingers:1.5), (Ugly Fingers:1.5), (extra digit and hands and fingers and legs and arms:1.4), crown braid, ((2girl)), (deformed fingers:1.5), (long fingers:1.2), (bad-artist-anime), bad-artist, bad hand
Executar localmente
Como instalar
O que é ComfyUI? Um guia para iniciantes sobre nós, fluxos de trabalho e o primeiro gráfico
17 de Dez de 2025
animagineXLV31_v30.safetensors
Os downloads são servidos pelo Civitai. Alguns criadores pedem login no Civitai primeiro.
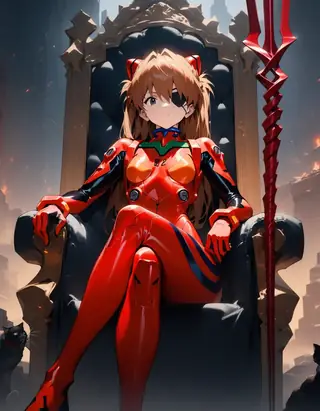
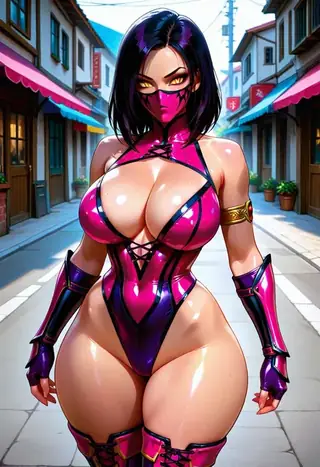
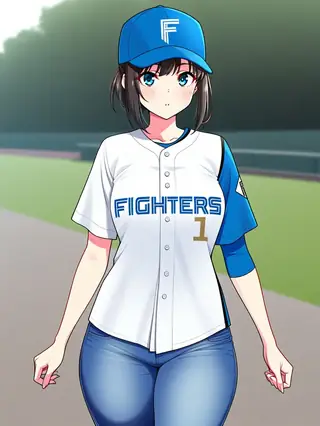
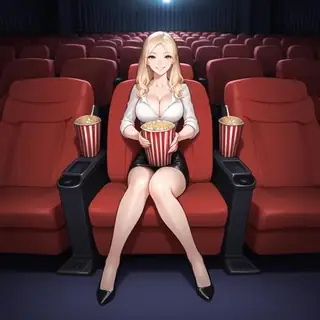
Animagine XL V3.1 é um modelo base para a família Stable Diffusion XL 1.0 listado no ModelTrends.ai, um catálogo somente leitura de modelos de IA de código aberto para imagem, vídeo e texto. Compare-o com outros modelos Stable Diffusion XL 1.0, veja a pontuação de calor para acompanhar a tendência e abra-o no PirateDiffusion ou BitVector para experimentar.
Navegar por família de modelos
Modelos Text / LLM
434
Modelos Anima
528

Modelos Chroma
19

Modelos Fibo
2
Modelos Flux
1,496
Modelos Flux 2 / Klein
1,239

Modelos Flux 3
3

Modelos Moss
3

Modelos Iris
1
Modelos MiniMax H3
364
Modelos Hunyuan
204
Modelos Ideogram
20
Modelos Krea2
717
Modelos Qwen
20
Modelos Qwen2
47
Modelos Ltx2
153