
Setsuna_LTX2 Beta1
7772°
<setsuna-ltx2>
Apps que suportam as tags do ModelTrends permitem que você execute/instale modelos copiando este código no seu prompt, sem precisar configurar nada. Procure nosso ícone em apps que suportam, como o Prism (abaixo).
Executar modelo
Ofertas / Anúncios

Easy Creator (Prism) Web
Ilimitado · taxa fixa
Melhor para iniciantes. Fluxos de trabalho poderosos, curva de aprendizado baixa.

PirateDiffusion Telegram
Ilimitado · taxa fixa
Crie vídeos, imagens, personas de chat personalizadas e muito mais.

Pro studio (SpyGlass) Web
Ilimitado · taxa fixa
Navegue por modelos, renderize e refine de qualquer navegador ou celular.

Discord bot (Vector)
Ilimitado · taxa fixa
Adicione o Vector ao seu servidor ou entre no Discord do Vector. Crie qualquer coisa!

Unified Editor Web
Ilimitado · taxa fixa
Editor para imagens e vídeos: renderize, edite, aumente a resolução e mais em uma única página.

Civitai Web
Pague por uso
Gere no site do Civitai; cada imagem é paga com créditos Buzz.

Apps locais Local
Requer configuração
Instale programas locais se seu computador tiver hardware compatível.

ModelDuel Web
Pague por uso
Gere o mesmo prompt em até 50 modelos checkpoint/base ao mesmo tempo.

by MengY_Madrigal - Setsuna_LTX2-Beta1
Notas do criador
This is a test LoRA model based on LTX-2, trained on 44 videos (most with audio) using LTX Trainer. The Lora still has some problems, but here I'd like to share some experiences from the training process.
LTX-2 has significant limitations with Japanese language support, which appears to be a base model capability issue—most Japanese kanji characters cannot be pronounced correctly. However, there are some impressive aspects: lip-sync and audio cloning show great promise. The model fits quickly and shows results rapidly, but I believe more diverse training data (video dynamics, audio variations, etc.) is needed for better outcomes.
Dataset Caption
I highly recommend using Gemini for dataset captioning. Gemini can directly process both video and audio, delivering excellent results. While ComfyUI workflows with other caption nodes + Whisper audio recognition + refine are possible, they're not particularly recommended.
Agent Prompt
I used the following prompt for video analysis:
You are a professional video analysis assistant responsible for generating descriptive text for video training datasets. Please analyze this video and output the description in the following format:
【Output Format】
Visual content: [Detailed description of visual content]
Speech transcription: [Transcribe dialogue content, omit this line if none]
Sounds: [Describe sounds and music, omit this line if none]
On-screen text: [List on-screen text, omit this line if none]
【Rules】
1. Use plain text format, no Markdown bold or other formatting
2. "Visual content:" is required; omit entire lines (not "None") if other sections are empty
3. Descriptions should be natural and fluid, suitable for video generation model training
4. Focus on: actions, scenes, camera movement, lighting, atmosphere, emotions
5. Use present continuous tense for actions (e.g., is walking, is standing)
【Visual Content Description Points】
- Subject's actions and behaviors
- Scene environment and background details
- Camera movements (push, pull, pan, tilt, close-up, wide-angle, etc.)
- Lighting and color tone (warm light, cool light, backlight, soft light, etc.)
- Overall atmosphere and mood (serene, tense, warm, etc.)
- Composition and visual elements
Refine Prompt
After generation, use this prompt to convert structured descriptions into natural paragraphs:
You are a video description expert. Now you need to rewrite structured video descriptions into completely natural paragraph form.
【Task】
Rewrite the segmented video description into a smooth, natural paragraph, as if someone is describing what they see in the video.
【Rewriting Requirements】
1. Completely remove all labels (don't write "Visual content:", "Speech:", "Sounds:", etc.)
2. Naturally merge all information (visuals + dialogue + sounds into one fluid paragraph)
3. Like storytelling (use third-person perspective, present tense, vivid and specific with visual appeal)
4. Maintain technical details (camera movement, lighting, atmosphere descriptions should be preserved but naturally integrated)
Preprocessing Configuration
To prevent VRAM overflow, I used multiple bucket settings:
-
Maximum resolution: 768×?, 25 frames
-
Minimum resolution: 256×?, 121 frames
-
Unified frame rate: 24fps
-
Frame count requirement: Must satisfy frame_count % 8 == 1 (e.g., 1, 9, 17, 25...)
Training Configuration
Using RTX 4090 (48GB VRAM), no fp8/quanto quantization needed, training config was barely modified.
Training Progress:
-
Sampling every 400 steps
-
First sample (400 steps) already captured basic character features
-
At 800 steps, ComfyUI testing showed incomplete character feature retention
-
Total training: 3400 steps (approximately 8 hours)
-
Final weight used: 2200 steps (1400 steps might also work well)
Testing Findings
Prompt Impact
Prompts significantly affect results:
-
Without background description, likely generates simple solid color backgrounds
-
Need detailed descriptions of character movements (hair flowing, etc.)
-
Overall motion tends to be minimal
Workflow Configuration
Using official T2V workflow, found second-pass sampling has significant impact:
-
First pass (720p): More aligned with LoRA characteristics but slightly blurry
-
Second pass (spatial upscale): Clearer, but audio quality slightly degraded
-
Without LoRA in second pass, noticeable differences appear—more 2.5D style, most obvious in lip-sync details (presence/absence of teeth)
Interesting Discovery
Using cinematic-style descriptions produces interesting effects.
Future Plans
Planning to test training with larger-scale datasets.
Reference Documentation:
Palavras-gatilho
Setsuna
SHA256
4810A51C5F1AFC0A5563FEF6FB49F97139080EF0A768D62A54B74A27EB27BF98
Ranking badge
Updated Oct 22, 2026

Made this model? Show this badge on your page.
Paste it into your Hugging Face card or Civitai description.
Also ranked: #32 Hottest Ltx2 LoRA
Not this creator?
Get your own badge
Tendência de popularidade de Setsuna_LTX2 Beta1
Pontuação de calor desde 11 Jan 2026
Pontuação de destaque
7,772°
Esta semana
n/a
Ainda não lançado/monitorado
Este mês
n/a
Ainda não lançado/monitorado
Último ano
n/a
Ainda não lançado/monitorado
7,000°
Piso
A escala vai de 0° a 9.999°. Tudo abaixo de 7,000° é reservado para modelos que nenhuma fonte reportou ainda, que carregam um número provisório ali para as listas ficarem completas. 7,000° é onde começam os dados medidos: um modelo com dados reais mas quase nenhum download fica no piso, e as medições preenchem os graus acima dele. O piso não diz nada sobre o modelo; só os graus acima dele dizem, e são eles que diferenciam um modelo do outro.
+644°
Downloads no Civitai
139 downloads desta versão exata no Civitai. Downloads são o ingrediente mais pesado e são contados numa escala logarítmica: dez vezes os downloads adicionam os mesmos 300°, então um modelo com um milhão de downloads não é mil vezes mais quente que um com mil. As seis fontes de downloads compartilham esse termo, dividido entre elas proporcionalmente aos seus contadores.
+185°
Curtidas
16 curtidas e thumbs up nas fontes. Uma curtida vale metade de um download, na mesma escala logarítmica.
+2°
Taxa de adoção
Cerca de 0 downloads por dia, medidos entre duas leituras das fontes, nunca estimados por média de vida útil. A velocidade pesa um quarto do termo de downloads, então um surto recente aparece sem deixar um pico de um dia superar anos de uso.
+100°
Impulso da família
+100° porque este é um LoRA de uma família que o site está promovendo agora. É um impulso limitado dentro da pontuação e listado aqui abertamente; nunca pode esconder um modelo ou superar uma diferença de mil vezes em downloads.
−159°
Idade
−159° porque os pesos da família Ltx2 saíram em 2025. Todo modelo herda a idade dos pesos em que foi construído: 150° por ano, até 750°, e continua crescendo até lá. Sem isso, o topo da lista seria só checkpoints de 2022 e 2023 baseados em downloads que tiveram anos para acumular.
Mostrar detalhamento
Cada número neste site pode ser verificado. A pontuação de popularidade deste modelo é 7,772°, e aqui ela é construída um ingrediente de cada vez, com o total acumulado após cada um: o piso, os graus que cada fonte adiciona, o bônus pelo tipo de modelo e o que a idade dos pesos subtrai. As cores são as faixas do gráfico acima. O glossário no final define cada termo.
- 1Comece pelo piso.Por que 7,000° e não zero: a escala vai de 0° a 9.999°, e a parte abaixo de 7,000° é reservada para modelos que nenhuma fonte reportou ainda, que carregam um número provisório ali para as listas ficarem completas e nunca ficarem acima de um modelo com dados. 7,000° é onde começam os dados medidos. Um modelo com dados reais mas quase nenhum download fica aqui; tudo que vem depois é medição, e o espaço acima do piso tem dez passos de dez vezes mais downloads, com 300° cada. O piso é o mesmo para todo modelo, então ele não decide nada; os graus acima dele é que decidem.7,000°total acumulado
- 2Some as downloads.139 equivalentes a downloads no total, de Downloads no Civitai. Dez vezes os downloads adicionam o mesmo 300°, então o tamanho importa, mas nunca domina a pontuação.+644°7,644°total acumulado
- 3Some os likes.16 likes e joinhas, valendo metade de um download.+185°7,829°total acumulado
- 4Adicione a taxa de adoção.Cerca de 0 downloads por dia agora, medido entre duas leituras, valendo um quarto do peso.+2°7,831°total acumulado
- 5Impulso familiar.Um empurrão aberto e limitado para LoRAs de uma família que este site está promovendo agora.+100°7,931°total acumulado
- 6Remova a idade.Os pesos Ltx2 saíram em 2025: 150° por ano, até 750°, crescendo até lá.−159°7,772°total acumulado
- =A pontuação heat.Onde este modelo está em todas as listas deste site. Nada mais altera isso.7,772°
Glossário: os termos usados aqui
- Pontuação heat
- Um número que mostra o quanto um modelo está sendo usado e desejado agora, de 0° a 9.999°. Toda lista neste site que diz mais quente é ordenada por ele e só por ele.
- Limite mínimo
- Os 7.000° que todo modelo com dados reais começa. A escala vai de 0° a 9.999°; a parte abaixo do limite é para substitutos (modelos sem dados), para que um modelo com dados sempre fique acima de um sem. O limite é igual para todos e não decide nada; os graus acima dele são a medida.
- Equivalentes a downloads
- Tudo que a pontuação trata como download, somado: downloads em si, cada torrent seeder como 1.000, cada imagem AI Horde e cada execução em site de geração como um.
- Escala logarítmica
- Contando de dez em dez, não de um em um: ir de 1.000 para 10.000 downloads adiciona os mesmos graus que ir de 10.000 para 100.000. Isso evita que gigantes abafem tudo.
- Likes
- Joinhas e likes de todas as fontes, valendo metade de um download na escala logarítmica.
- Taxa de adoção
- Quantos downloads por dia um modelo recebe agora, pela diferença entre duas leituras de uma fonte. Um quarto do peso do termo download.
- Medido e estimado
- Medido significa que existem duas leituras de uma fonte e a diferença é real. Estimado significa que só se sabe o total de hoje e o passado é distribuído ao longo da vida do modelo; o site indica qual está mostrando.
- Seeder
- Alguém que mantém uma cópia dos pesos online para outros baixarem via torrent, ou um espelho hospedado fazendo o mesmo. Cada um conta como 1.000 downloads.
- AI Horde
- Uma rede voluntária que gera imagens de graça em computadores doados. O número de imagens feitas com um modelo é público, e cada uma conta como um download.
- Sites de geração
- Sites que hospedam suas próprias cópias de um modelo e deixam as pessoas gerarem com ele, como PixAI, SeaArt e Yodayo. Os downloads deles contam como os do Civitai e cada geração conta como um download.
- Tokens OpenRouter
- Um modelo de texto servido via API, como Claude ou GPT, não tem pesos para baixar, então seu uso é medido em tokens: os pedaços de texto que ele leu e escreveu via OpenRouter, um gateway usado por muitos apps, nos últimos 30 dias. Cada 10,000,000 tokens contam como um download. Fonte: OpenRouter (openrouter.ai/rankings), CC BY 4.0.
- Modelo completo (checkpoint)
- Os pesos em si, o arquivo que gera sozinho. Ganha um bônus porque complementos dependem dele.
- LoRA e embedding
- Arquivos pequenos que direcionam os pesos de outra pessoa para um estilo, personagem ou conceito. Não podem rodar sozinhos.
- Família e pesos
- A base em que um modelo é construído, como SD 1.5, SDXL, Flux ou Wan. Todo modelo herda a data de lançamento dos pesos da sua família.
- Idade
- Pontos retirados conforme há quanto tempo os pesos da família foram lançados: 150° por ano, até 750°. Mantém os downloads antigos que tiveram anos para acumular, evitando que saiam do topo da lista.
- Impulso da família
- Um pequeno empurrão limitado para LoRAs de uma família que este site está promovendo agora, sempre listado na divisão.
- Pontuação provisória
- Um número estável abaixo do mínimo dado a um modelo que ainda não tem dados de fonte, para a lista ficar completa. Nunca fica acima de um modelo com dados.
- Novo! (período de carência)
- Um modelo com menos de 7 dias mostra Novo! em vez de uma pontuação e não ocupa lugar no ranking. Sua pontuação é calculada desde o primeiro dia, mas um modelo com um dia cresce mais rápido que qualquer outro, então sem a espera o #1 da semana seria sempre o que saiu ontem, não o que se manteve por uma semana.
- Tendência
- Como o crescimento de um modelo num período se compara com o crescimento típico dos modelos no mesmo período. Crescimento mais rápido que o típico indica alta, mais lento indica queda.
- Modelo típico
- O meio do catálogo: metade dos modelos com número cresceu mais rápido no período, metade mais devagar.
Como a popularidade deste modelo mudou em relação ao resto do catálogo: seu crescimento em downloads, curtidas e uso em cada período, medido contra o crescimento típico dos modelos no mesmo período, junto com sua pontuação de calor na época. Acima do crescimento típico significa alta, abaixo significa queda. O passado é reconstruído a partir dos totais de hoje, do primeiro dia do modelo e da velocidade de download medida quando existem duas leituras; um modelo que não existia no começo do período mostra n/a.
Renders de exemplo
Prompts e configurações compartilhados por quem fez estes renders no Civitai. Escolha um render para ver como foi feito.
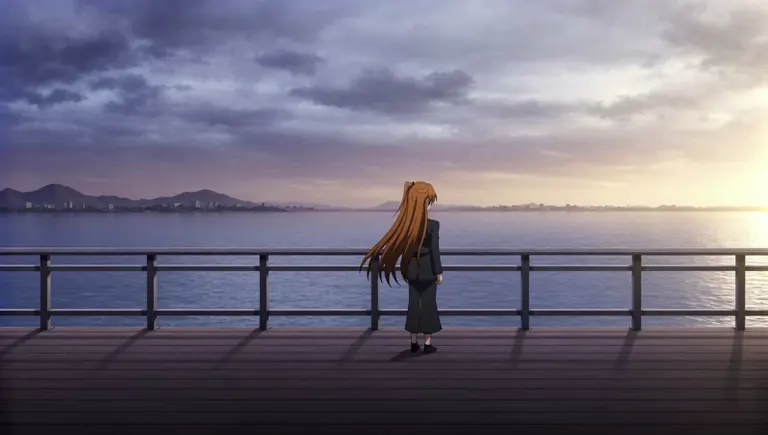
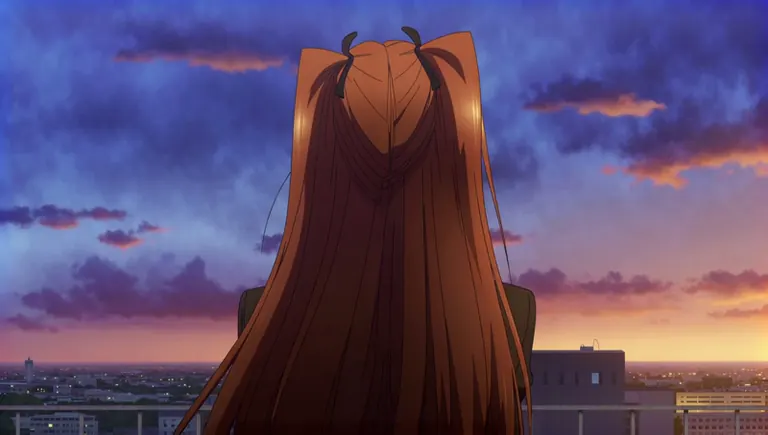
Nenhum prompt foi compartilhado com este render.
Nenhum prompt foi compartilhado com este render.
Nenhum prompt foi compartilhado com este render.
Nenhum prompt foi compartilhado com este render.
Executar localmente
SetsunaLtx2.safetensors
Os downloads são servidos pelo Civitai. Alguns criadores pedem login no Civitai primeiro.
Setsuna_LTX2 Beta1 é um LoRA para a família Ltx2 listado no ModelTrends.ai, um catálogo somente leitura de modelos de IA de código aberto para imagem, vídeo e texto. Compare-o com outros modelos Ltx2, veja a pontuação de calor para acompanhar a tendência e abra-o no PirateDiffusion ou BitVector para experimentar.
Navegar por família de modelos
Modelos Text / LLM
434
Modelos Anima
528

Modelos Chroma
19

Modelos Fibo
2
Modelos Flux
1,496
Modelos Flux 2 / Klein
1,239

Modelos Flux 3
3

Modelos Moss
3

Modelos Iris
1
Modelos MiniMax H3
364
Modelos Hunyuan
204
Modelos Ideogram
20
Modelos Krea2
717

Modelos Qwen
20
Modelos Qwen2
47
Modelos Ltx2
153