- #1
GLM 5.3
Z.ai | kontekst 1 048 576 tokenów | $0.08/M wejście, $4.80/M wyjście. GLM-5.3 to model dużej skali do rozumowania od Z.ai, stworzony do złożonej inżynierii oprogramowania i długoterminowych zadań agentowych. Obsługuje wejście i wyjście…Z.ai | kontekst 1 048 576 tokenów | $0.08/M wejście, $4.80/M wyjście. GLM-5.3 to model dużej skali do rozumowania od Z.ai, stworzony do złożonej inżynierii oprogramowania i długoterminowych zadań agentowych. Obsługuje wejście i wyjście tekstowe z oknem kontekstowym 1M tokenów, i poprawia GLM-5.2 w kodowaniu oraz w równowadze między wydajnością a efektywnością tokenów. Rozumowanie jest zawsze włączone i nie można go wyłączyć. Wspiera wysiłki rozumowania low, high i max; max jest ustawieniem domyślnym.
- #2
Nemotron 3.5 Lightning
NVIDIA | kontekst 262 144 tokenów | 0,07 USD/M wejście, 0,20 USD/M wyjście. NVIDIA Nemotron 3.5 Lightning to otwarty model mieszanki ekspertów od NVIDIA, z 3B aktywnych parametrów na 30B całkowitych. Nadaje się do przepływów pracy…NVIDIA | kontekst 262 144 tokenów | 0,07 USD/M wejście, 0,20 USD/M wyjście. NVIDIA Nemotron 3.5 Lightning to otwarty model mieszanki ekspertów od NVIDIA, z 3B aktywnych parametrów na 30B całkowitych. Nadaje się do przepływów pracy agentowych o wysokiej przepustowości oraz specjalistycznych zadań korzystających z dostosowań specyficznych dla domeny.
- #3
Nemotron 3 Super
NVIDIA | kontekst 262 144 tokenów | 0,08 USD/M wejście, 0,45 USD/M wyjście. NVIDIA Nemotron 3 Super to otwarty hybrydowy model MoE o 120 miliardach parametrów, aktywujący tylko 12 miliardów parametrów dla maksymalnej efektywności…NVIDIA | kontekst 262 144 tokenów | 0,08 USD/M wejście, 0,45 USD/M wyjście. NVIDIA Nemotron 3 Super to otwarty hybrydowy model MoE o 120 miliardach parametrów, aktywujący tylko 12 miliardów parametrów dla maksymalnej efektywności obliczeniowej i dokładności w złożonych zastosowaniach wieloagentowych. Zbudowany na hybrydowej architekturze Mamba-Transformer Mixture-of-Experts z wielotokenową predykcją (MTP), oferuje ponad 50% wyższą generację tokenów w porównaniu do czołowych otwartych modeli. Model posiada okno kontekstowe 1M tokenów dla długoterminowej spójności agenta, rozumowania między dokumentami i planowania wieloetapowego. Ukryty MoE umożliwia wywoływanie 4 ekspertów przy koszcie inferencji jednego, poprawiając inteligencję i generalizację. Trening RL w wielu środowiskach (ponad 10) zapewnia wiodącą dokładność w benchmarkach takich jak AIME 2025, TerminalBench i SWE-Bench Verified. W pełni otwarty z wagami, zestawami danych i przepisami na licencji NVIDIA Open License, Nemotron 3 Super umożliwia łatwą personalizację i bezpieczne wdrożenie wszędzie — od stacji roboczej po chmurę.
- #4

DeepSeek V4.1 Flash
DeepSeek | 1,048,576 token context | $0.04/M input, $0.68/M output. DeepSeek V4.1 Flash is a sparse mixture-of-experts model from DeepSeek, and the first built on the company's Causal Encoder-Decoder (CED) architecture. It activates 8B…DeepSeek | 1,048,576 token context | $0.04/M input, $0.68/M output. DeepSeek V4.1 Flash is a sparse mixture-of-experts model from DeepSeek, and the first built on the company's Causal Encoder-Decoder (CED) architecture. It activates 8B parameters on input and 16B on output from a 552B-parameter backbone, an asymmetric split that keeps per-token compute low relative to the model's total size. Image understanding is native to the architecture, with visual and text embeddings trained jointly from the start of pre-training rather than added afterward as in the earlier experimental V4 Flash Vision ExpOpens in new tab. It is suited for coding, terminal, and computer-use agents, along with long-horizon tasks that must run to completion across many steps and long-context analysis. Compressed KV caching cuts cache memory to roughly a quarter of the previous Flash generation, significantly reducing costs on agentic workloads. DeepSeek positions it as the cost-efficient tier of the V4.1 family and reports that it exceeds V4 ProOpens in new tab on performance, speed, and task completion time.
- #5
Gemma 4 26B A4B
Google | kontekst 262 144 tokenów | 0,09 USD/M wejście, 0,30 USD/M wyjście. Gemma 4 26B A4B IT to model Mixture-of-Experts (MoE) dostrojony instrukcyjnie od Google DeepMind. Pomimo 25,2 miliarda całkowitych parametrów, aktywuje tylko 3,8…Google | kontekst 262 144 tokenów | 0,09 USD/M wejście, 0,30 USD/M wyjście. Gemma 4 26B A4B IT to model Mixture-of-Experts (MoE) dostrojony instrukcyjnie od Google DeepMind. Pomimo 25,2 miliarda całkowitych parametrów, aktywuje tylko 3,8 miliarda na token podczas inferencji — dostarczając jakość bliską 31 miliardom przy ułamku kosztów obliczeniowych. Obsługuje multimodalne wejścia, w tym tekst, obrazy i wideo (do 60 sekund przy 1 klatce na sekundę). Posiada okno kontekstowe 256K tokenów, natywne wywoływanie funkcji, konfigurowalny tryb myślenia/rozumowania oraz wsparcie dla strukturalnych wyjść. Wydany na licencji Apache 2.0.
- #6
Qwen3.8 Flash
Qwen | kontekst 1 000 000 tokenów | 0,15 USD/M wejście, 0,47 USD/M wyjście. Qwen3.8 Flash to multimodalny model rozumowania od Alibaba. Nadaje się do wsparcia kodowania, przepływów pracy agentowych, rozumienia wizualnego, analizy…Qwen | kontekst 1 000 000 tokenów | 0,15 USD/M wejście, 0,47 USD/M wyjście. Qwen3.8 Flash to multimodalny model rozumowania od Alibaba. Nadaje się do wsparcia kodowania, przepływów pracy agentowych, rozumienia wizualnego, analizy dokumentów i baz kodu, interakcji na pulpicie, analizy wykresów oraz analizy długich materiałów wideo.
- #7
Qwen3.8 27B
Qwen | 1,000,000 token context | $0.24/M input, $2.20/M output. Qwen3.8 27B is an open-weight dense vision-language model from Qwen. It is suited for coding, professional workflows, research, multimodal interaction, and long-running agent…Qwen | 1,000,000 token context | $0.24/M input, $2.20/M output. Qwen3.8 27B is an open-weight dense vision-language model from Qwen. It is suited for coding, professional workflows, research, multimodal interaction, and long-running agent tasks, with flexible thinking that can be enabled or disabled.
- #8
Hy4 preview
Tencent | 1,048,576 token context | $0.83/M input, $2.50/M output. Tencent: Hy4 preview is a mixture-of-experts model from Tencent, with 49B active parameters out of 770B total. It is designed for coding agents, complex tool-use workflows,…Tencent | 1,048,576 token context | $0.83/M input, $2.50/M output. Tencent: Hy4 preview is a mixture-of-experts model from Tencent, with 49B active parameters out of 770B total. It is designed for coding agents, complex tool-use workflows, and productivity tasks that require planning, context continuity, and sustained multi-step execution.
- #9
Hy3
Tencent | 262,144 token context | $0.13/M input, $0.53/M output. Hy3 is a 295B-parameter Mixture-of-Experts model from Tencent (21B active, 192 experts with top-8 routing) built for reasoning, agentic workflows, and real-world production…Tencent | 262,144 token context | $0.13/M input, $0.53/M output. Hy3 is a 295B-parameter Mixture-of-Experts model from Tencent (21B active, 192 experts with top-8 routing) built for reasoning, agentic workflows, and real-world production use. It supports a configurable reasoning effort: a direct no-think mode by default, plus low and high chain-of-thought modes for complex math, coding, and multi-step problems. With a 256K context window, Hy3 targets long-horizon tasks, including improved coreference resolution, multi-turn constraint tracking, and stable tool-calling that generalizes across agent scaffoldings. Tencent positions it as a reliable, cost-effective option across coding, document processing, financial analysis, game development, and frontend design, with a strong emphasis on grounded, anti-hallucination behavior that answers when grounded and flags when evidence is missing rather than fabricating.
- #10
GLM 5.3 Flash
Z.ai | 1,048,576 token context | $0.02/M input, $0.72/M output. GLM-5.3-Flash is a native multimodal model from Z.ai. It is suited for efficient coding and long-horizon agent tasks. Its hybrid sparse and linear attention architecture…Z.ai | 1,048,576 token context | $0.02/M input, $0.72/M output. GLM-5.3-Flash is a native multimodal model from Z.ai. It is suited for efficient coding and long-horizon agent tasks. Its hybrid sparse and linear attention architecture maintains accurate long-context behavior while reducing compute overhead. Yes, the stealth model Ox Alpha was revealed to be ZAI's new model, GLM-5.3 Flash.
- #11
DeepSeek V4 Pro 0813
DeepSeek | 1,048,576 token context | $1.32/M input, $3.96/M output. DeepSeek V4 Pro 0813 is a large-scale mixture-of-experts model from DeepSeek. This is the GA release of DeepSeek V4 Pro. - #12
Gemma 4 31B
Google | 262,144 token context | $0.20/M input, $0.40/M output. Gemma 4 31B Instruct is Google DeepMind's 30.7B dense multimodal model supporting text and image input with text output. Features a 256K token context window, configurable…Google | 262,144 token context | $0.20/M input, $0.40/M output. Gemma 4 31B Instruct is Google DeepMind's 30.7B dense multimodal model supporting text and image input with text output. Features a 256K token context window, configurable thinking/reasoning mode, native function calling, and multilingual support across 140+ languages. Strong on coding, reasoning, and document understanding tasks. Apache 2.0 license.
- #13
gpt oss 120b
OpenAI | kontekst 131 072 tokenów | 0,15 USD/M wejście, 0,60 USD/M wyjście. gpt-oss-120b to otwarty model językowy Mixture-of-Experts (MoE) o 117 miliardach parametrów od OpenAI, zaprojektowany do zadań wymagających wysokiego rozumowania,…OpenAI | kontekst 131 072 tokenów | 0,15 USD/M wejście, 0,60 USD/M wyjście. gpt-oss-120b to otwarty model językowy Mixture-of-Experts (MoE) o 117 miliardach parametrów od OpenAI, zaprojektowany do zadań wymagających wysokiego rozumowania, agentowych i ogólnego zastosowania produkcyjnego. Aktywuje 5,1 miliarda parametrów na pojedyncze przejście i jest zoptymalizowany do pracy na pojedynczym GPU H100 z natywną kwantyzacją MXFP4. Model obsługuje konfigurowalną głębokość rozumowania, pełny dostęp do łańcucha myślenia oraz natywne użycie narzędzi, w tym wywoływanie funkcji, przeglądanie i generowanie strukturalnych wyjść.
- #14
Ling 3.0 Flash VL
inclusionAI | 131,072 token context | $0.06/M input, $0.18/M output. Ling 3.0 Flash VL builds on Ling 3.0 Flash (124B total / 5.5B active MoE from InclusionAI), further strengthening its language capabilities while adding native visual…inclusionAI | 131,072 token context | $0.06/M input, $0.18/M output. Ling 3.0 Flash VL builds on Ling 3.0 Flash (124B total / 5.5B active MoE from InclusionAI), further strengthening its language capabilities while adding native visual perception and advanced visual agent capabilities. Hybrid instant/reasoning model with tool calling.
- #15
MiniMax M3
MiniMax | kontekst 1 048 576 tokenów | $0.30/M wejście, $1.20/M wyjście. MiniMax-M3 to multimodalny model bazowy od MiniMax. Obsługuje wejścia tekstowe, obrazowe i wideo z wyjściem tekstowym, oknem kontekstowym 1M tokenów, nadaje się do…MiniMax | kontekst 1 048 576 tokenów | $0.30/M wejście, $1.20/M wyjście. MiniMax-M3 to multimodalny model bazowy od MiniMax. Obsługuje wejścia tekstowe, obrazowe i wideo z wyjściem tekstowym, oknem kontekstowym 1M tokenów, nadaje się do długoterminowej pracy agentowej, kodowania i użycia narzędzi. Zbudowany na MiniMax Sparse Attention (MSA), który zastępuje pełną uwagę wyborem bloków KV, aby zmniejszyć obciążenie obliczeniowe na token przy długim kontekście — około 1/20 kosztu poprzedniej generacji przy 1M tokenów, z znacznie szybszym wypełnianiem i dekodowaniem, zachowując jakość w większości zadań. Trenowany jako natywny model multimodalny na przeplatanych danych i dostrojony do wieloetapowej, produkcyjnej współpracy poprzez interaktywny framework symulatora użytkownika, model jest ukierunkowany na trwałe, wieloetapowe zadania, a nie na jednorazowe wykonanie.
- #16
Laguna S 2.1
Poolside | kontekst 1 048 576 tokenów | $0.09/M wejście, $0.18/M wyjście. Laguna S 2.1 to najnowszy model agenta kodującego od PoolsideOpens in new tab. Laguna S 2.1 to model z 118 mld parametrami łącznie i 8 mld aktywnych parametrów,…Poolside | kontekst 1 048 576 tokenów | $0.09/M wejście, $0.18/M wyjście. Laguna S 2.1 to najnowszy model agenta kodującego od PoolsideOpens in new tab. Laguna S 2.1 to model z 118 mld parametrami łącznie i 8 mld aktywnych parametrów, osiągający 70.2% na Terminal-Bench 2.1 i 40.4% na DeepSWE, co czyni go jednym z najsilniejszych modeli kodujących w swojej kategorii. Wagi otwarte na licencji OpenMDW-1.1. Laguna S 2.1 jest przeznaczona do zastosowań w inżynierii oprogramowania i agentowej pracy kodującej, a użytkownik jest odpowiedzialny za potwierdzenie jej odpowiedniości do zamierzonego zastosowania. Laguna S 2.1 podlega licencji OpenMDW-1.1Opens in new tab i powinna być używana zgodnie z Polityką Akceptowalnego Użytkowania PoolsideOpens in new tab. Zalecamy nie omijać zabezpieczeń Laguna S 2.1 bez wdrożenia równoważnych środków odpowiednich dla danego zastosowania. Prosimy o zgłaszanie luk bezpieczeństwa lub obaw dotyczących bezpieczeństwa na adres [email protected]. Jeśli korzystasz z Laguna S 2.1 za darmo, możemy używać twoich danych wejściowych i wyjściowych do trenowania i ulepszania naszych modeli.
- #17
Nex N2.5 Pro
Nex AGI | kontekst 262 144 tokenów | $0.07/M wejście, $0.25/M wyjście. Nex-N2.5 to model agentowy stworzony do przekształcania celów w działające, zweryfikowane wyniki. Jego główną siłą jest agentowe kodowanie w wizualnej pętli sprzężenia…Nex AGI | kontekst 262 144 tokenów | $0.07/M wejście, $0.25/M wyjście. Nex-N2.5 to model agentowy stworzony do przekształcania celów w działające, zweryfikowane wyniki. Jego główną siłą jest agentowe kodowanie w wizualnej pętli sprzężenia zwrotnego: potrafi eksplorować bazy kodu, wprowadzać zmiany w wielu plikach, uruchamiać polecenia, uruchamiać aplikacje, wchodzić w interakcje z przeglądarką i interfejsami pulpitu oraz testować oprogramowanie z perspektywy użytkownika. Gdy obserwowane zachowanie nie odpowiada zamierzonemu rezultatowi, Nex-N2.5 potrafi zdiagnozować problem, poprawić implementację i ponownie przetestować. Czyni go to szczególnie skutecznym w autonomicznej inżynierii oprogramowania, testowaniu GUI, automatyzacji obsługi komputera, głębokich badaniach i przepływach pracy naukowych, gdzie sukces musi być wykazany w środowisku, a nie tylko wywnioskowany z wygenerowanego kodu.
- #18
Kimi K3
MoonshotAI | 1,048,576 token context | $0.30/M input, $11.94/M output. Kimi K3 is a 2.8T parameter open-weight multimodal reasoning model from Moonshot AI. It is suited for complex coding, knowledge work, and long-horizon agentic…MoonshotAI | 1,048,576 token context | $0.30/M input, $11.94/M output. Kimi K3 is a 2.8T parameter open-weight multimodal reasoning model from Moonshot AI. It is suited for complex coding, knowledge work, and long-horizon agentic workflows, and is particularly strong at navigating large repositories, using tools, debugging, and iterating against images, logs, tests, and runtime feedback. Its architecture uses KDA and Attention Residuals for computational efficiency.
- #19
Evil Boss Special Models
Illustrious checkpoint, shared as a torrent on CivitasBay (v1.0). The model is also listed on Civitai. - #20
DeepSeek V4 Flash 0423
DeepSeek | kontekst 1 048 576 tokenów | $0.09/M wejście, $0.18/M wyjście. DeepSeek V4 Flash to zoptymalizowany pod kątem efektywności model Mixture-of-Experts od DeepSeek z 284 mld parametrów łącznie i 13 mld aktywowanych, obsługujący okno…DeepSeek | kontekst 1 048 576 tokenów | $0.09/M wejście, $0.18/M wyjście. DeepSeek V4 Flash to zoptymalizowany pod kątem efektywności model Mixture-of-Experts od DeepSeek z 284 mld parametrów łącznie i 13 mld aktywowanych, obsługujący okno kontekstowe 1M tokenów. Zaprojektowany do szybkiej inferencji i przepływów pracy o dużej przepustowości, zachowując silne możliwości rozumowania i kodowania. Model zawiera hybrydową uwagę dla efektywnego przetwarzania długiego kontekstu. Wspiera wysiłki rozumowania high i xhigh; xhigh odpowiada maksymalnemu rozumowaniu. Doskonale nadaje się do zastosowań takich jak asystenci kodowania, systemy czatu i przepływy pracy agentów, gdzie ważna jest responsywność i efektywność kosztowa.
- #21
Nemotron 3 Ultra
NVIDIA | kontekst 262 144 tokenów | $0.60/M wejście, $2.40/M wyjście. NVIDIA Nemotron 3 Ultra to otwarty model do rozumowania i orkiestracji od NVIDIA, z 55 mld aktywnych parametrów z 550 mld łącznie (MoE). Zbudowany na hybrydowej…NVIDIA | kontekst 262 144 tokenów | $0.60/M wejście, $2.40/M wyjście. NVIDIA Nemotron 3 Ultra to otwarty model do rozumowania i orkiestracji od NVIDIA, z 55 mld aktywnych parametrów z 550 mld łącznie (MoE). Zbudowany na hybrydowej architekturze Transformer-Mamba mixture-of-experts, obsługuje wejście i wyjście tekstowe z oknem kontekstowym do 1M tokenów. Nadaje się do długotrwałych przepływów pracy agentowych, w tym orkiestracji agentów, agentów kodujących, głębokich badań i złożonych zadań korporacyjnych. Szczególnie silny w wieloetapowym rozumowaniu i planowaniu, z wysokoprzepustową inferencją zaprojektowaną dla dużych potoków agentowych. Jest częścią rodziny otwartych modeli NVIDIA Nemotron dla agentowej AI.
- #22
DeepSeek V4 Pro 0423
DeepSeek | 1,048,576 token context | $0.96/M input, $1.91/M output. DeepSeek V4 Pro is a large-scale Mixture-of-Experts model from DeepSeek with 1.6T total parameters and 49B activated parameters, supporting a 1M-token context window. It…DeepSeek | 1,048,576 token context | $0.96/M input, $1.91/M output. DeepSeek V4 Pro is a large-scale Mixture-of-Experts model from DeepSeek with 1.6T total parameters and 49B activated parameters, supporting a 1M-token context window. It is designed for advanced reasoning, coding, and long-horizon agent workflows, with strong performance across knowledge, math, and software engineering benchmarks. Built on the same architecture as DeepSeek V4 Flash, it introduces a hybrid attention system for efficient long-context processing. Reasoning efforts high and xhigh are supported; xhigh maps to max reasoning. It is well suited for complex workloads such as full-codebase analysis, multi-step automation, and large-scale information synthesis, where both capability and efficiency are critical
- #23
GLM 5.2
Z.ai | 1,048,576 token context | $0.04/M input, $9.00/M output. GLM 5.2 is a large-scale reasoning model from Z.ai. It supports text input and output with a 1M-token context window, and is suited for long-horizon agent workflows,…Z.ai | 1,048,576 token context | $0.04/M input, $9.00/M output. GLM 5.2 is a large-scale reasoning model from Z.ai. It supports text input and output with a 1M-token context window, and is suited for long-horizon agent workflows, project-level software engineering, and complex multi-step automation. Reasoning efforts high and xhigh are supported; xhigh maps to max reasoning. It is particularly strong at coding and tool use across long-running tasks, able to maintain engineering context and follow standards consistently through a full development workflow, from requirements to multi-platform deployment, in a single task.
- #24
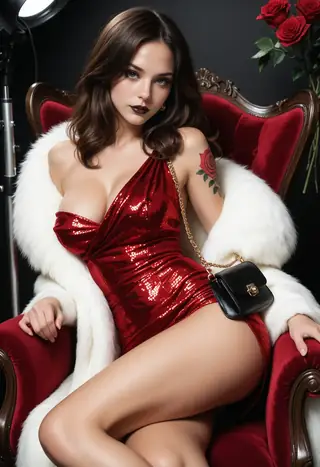
UnNamedIXL Realistic model IllustriousXL V2.0 based
Recommended 40 steps at 6 guidance - #25
Asian Fusion Krea2 (Uncensored)
Krea 2 checkpoint, shared as a torrent on CivitasBay (v2.0 Q4). Civitai no longer lists this model; the torrent is what remains publicly available, after 410 downloads there. - #26
DeepSeek V4 Flash 0731
DeepSeek | 1,048,576 token context | $0.01/M input, $1.28/M output. DeepSeek V4 Flash 0731 is a sparse mixture-of-experts model from DeepSeek, with 13B active parameters out of 284B total. This re-post-trained revision is suited for…DeepSeek | 1,048,576 token context | $0.01/M input, $1.28/M output. DeepSeek V4 Flash 0731 is a sparse mixture-of-experts model from DeepSeek, with 13B active parameters out of 284B total. This re-post-trained revision is suited for coding, reasoning, and agent workflows. This is the GA release of DeepSeek V4 Flash.
- #27
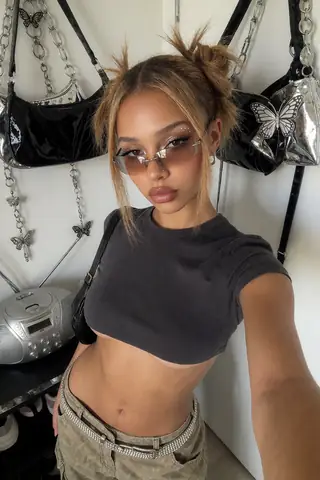
Aesthetic Amateur Photo Krea V4
by powerpuff - Aesthetic Amateur Photo V4 - Another amateur photo LoRA aimed at making images feel more realistic and closer to everyday smartphone or social media photos. Expect sharper details, brighter colors, and a more casual, natural…by powerpuff - Aesthetic Amateur Photo V4 - Another amateur photo LoRA aimed at making images feel more realistic and closer to everyday smartphone or social media photos. Expect sharper details, brighter colors, and a more casual, natural look overall.
- #28
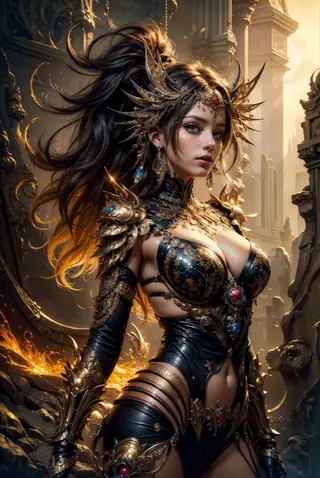
NoosphereREAL
NoosphereREAL by skumerz. Just a bit more detail, sharper, more realistic than regular Noosphere, espeically when you add tags like RAW photo, realism, realistic, hdr:1.5 Has some fantasy elements to it. I want to give tamtamx1332 a huge…NoosphereREAL by skumerz. Just a bit more detail, sharper, more realistic than regular Noosphere, espeically when you add tags like RAW photo, realism, realistic, hdr:1.5 Has some fantasy elements to it. I want to give tamtamx1332 a huge thank you for helping me with this ♥️ (please go give him a follow https://www.instagram.com/nosecretsai/) (https://civitai.com/user/tamtamx1332 ) Pruned version as baked VAE // Full has no baked in VAE use: (worst quality:2), (low quality:2), (normal quality:2), (monochrome), normal quality, lowres, watermark, badhandv4 or (worst quality:2), (low quality:2), (normal quality:2), lowres, bad anatomy, (monochrome), (grayscale), text, signature, watermark, logo If you want to achieve similar results.
- #29
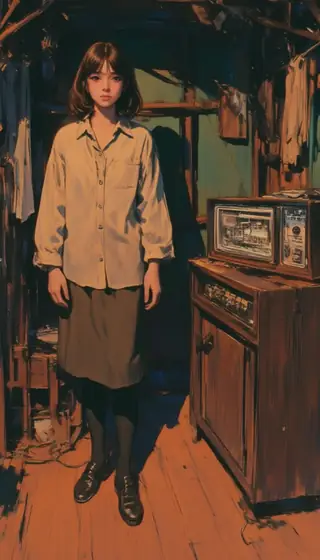
lyh_anime_Flux
Flux.1 D checkpoint, hosted on Yodayo with 23,546 generation runs there. The model is also listed on Civitai. - #30
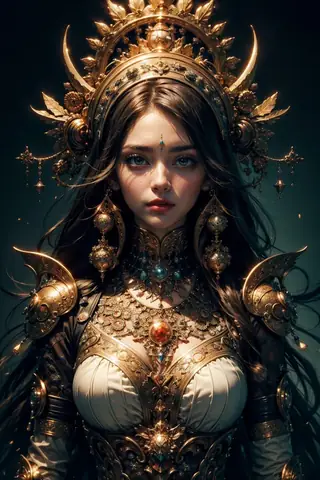
Noosphere
Noosphere by skumerz. V4.2 Still has fantasy elements, less dark, more delicate features, tried to fix some stuff to make it a bit better (different negative embeddings give it different effects so experiment, explore) Just used block…Noosphere by skumerz. V4.2 Still has fantasy elements, less dark, more delicate features, tried to fix some stuff to make it a bit better (different negative embeddings give it different effects so experiment, explore) Just used block merging on older models. Please use adetailer to fix them faces - https://github.com/Bing-su/adetailer I use this for negatives for most images: (worst quality:2), (low quality:2), (normal quality:2), (monochrome), normal quality, lowres, watermark, badhandv4 Or (worst quality:2), (low quality:2), (normal quality:2), lowres, bad anatomy, normal quality, ((monochrome)), ((grayscale)), ((text, font, logo, copyright, watermark:1)), easynegative, badhandv4 [or just use whatever you want baby]
- #31
- #32
Spreading Anus Gape, Hard spreading Krea2
by quadratrund - Spreading Anus Gape, Hard spreading - Strength: 0.8 or more - #33
Windy Krea
Krea 2 checkpoint, 2 torrents on CivitasBay (Windy Krea2 Turbo 0.1INT8, 0.1INT8 CONVROT). Civitai no longer lists this model; the torrent is what remains publicly available, after 501 downloads there. - #34
H3 LTX 2.3 I2V T2V Video Reasoning lora VBVR H3 VBVR Pro
By - MisticRain69 Motion improver for H3 - #35
Real Cum realcum krea2 beta
By alejnd77 - (beta) Helper LoRA for creating more realistic cum textures for Krea 2 - #36
Side Riding Cowgirl MiniMaxH3 2
by az420 - Side Riding Cowgirl V2 - #37
Coma
Coma by skumerz. This model has a certain style to it, kinda like niji and kind of like anime? There are 3 versions: Sfw, Nsfw, Hard - #38
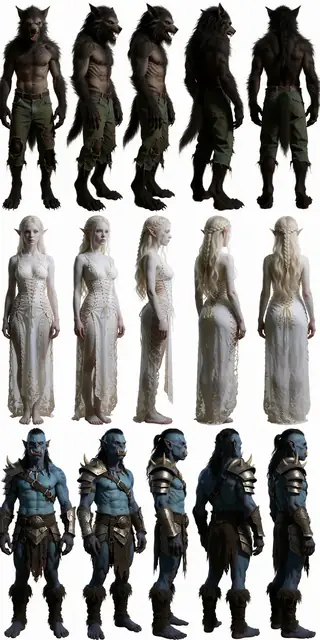
Character sheet Helper
by LOREVER - Character sheet Helper Full Body - This model is designed to help you build a character sheet for a character you plan to train, create references for generative video, or maybe create a 3D model... It generates the same…by LOREVER - Character sheet Helper Full Body - This model is designed to help you build a character sheet for a character you plan to train, create references for generative video, or maybe create a 3D model... It generates the same character from multiple angles so you can isolate several images and expand your dataset. It’s far from perfect, Krea2 can already do something similar without a LoRA, with mixed results, but with this LoRA, using the triggerword (shown in the description) should reduce the number of generations needed. Just add the most precise description possible of your character.
- #39
Ahegao Face Minimax H3 v2
by kermitfrog1202 - Ahegao Face V2 - #40
Free Pussy
by kermitfrog1202 - Free Pussy - #41
Minimax H3 Perfect Fingering
by hboxgames132 - Minimax H3 - Perfect Fingering - #42
Wrong hole Expression
by quadratrund - Wrong hole Expression - keep in mind, this lora is only the expression not the concept of the sexual acts in the samples! You won't be able to prompt doggystyle with this lora. Strength: 0.7-0.8 - #43
Jerking Off
By kermitfrog1202 - Trigger: [He/She] is jerking off. Author recommends using a penis LoRA alongside it in order to get the best results. - #44
HARUKI_MIX
Pony checkpoint, shared as a torrent on CivitasBay (★Pony_v2.3). The model is also listed on Civitai. - #45
Doggy Style Sex Minimax H3 V1
by kermitfrog1202 - Doggy Style Sex V1 - #46
Jib Mix Krea
(Testing, do not attempt to render with this right now) By J1B (v5) - 13/09/2026 - Jib Mix Krea v5 Ghost Pepper +Removes the yellow tint that v4 suffered from. +Less noticeable grid lines that v4 suffered from. +Defaults more to NSFW.…(Testing, do not attempt to render with this right now) By J1B (v5) - 13/09/2026 - Jib Mix Krea v5 Ghost Pepper +Removes the yellow tint that v4 suffered from. +Less noticeable grid lines that v4 suffered from. +Defaults more to NSFW. +More amateur photo look. -Can often by PIV unprompted. -Slightly less detailed than Jib Mix v4 Habanero SWF (that usually happens with NSFW datasets) Seems to has reduced art style abilities somewhat. Added int8_convrot Version: https://civitai.red/api/download/models/3102188?fileId=2985178 It seems slightly better quality and more natural look.
- #47
MFCG Washed Mix
Pony checkpoint, shared as a torrent on CivitasBay (v1.0). The model is also listed on Civitai. - #48
Cowgirl Position
By - kermitfrog1202 Trigger: She rides him in the cowgirl position. - #49
Mrpopo's Krea2 Anime/Art enhanced
by Mrpopo714 - Mrpopo's Krea2 Anime enhanced - #50
Giant Dom IL | Fantasy Sex concept
by Shrekman17 - Giant Dom IL | Fantasy Sex concept
Gorąco to nasz wewnętrzny wskaźnik trendu od chłodnego do 9999°. Zmienia się codziennie wraz z sygnałami użycia i popularności ze społeczności i serwisów wokół każdego modelu. Ranking obejmuje modele bazowe, LoRA, embeddingi i modele tekstowe wszystkich rodzin w katalogu.
Przeglądaj według rodziny modeli