
Erros e soluções
"Torch não compilado com CUDA habilitado": Como corrigir no ComfyUI (2026)
"Torch não compilado com CUDA habilitado" significa que uma versão do PyTorch só para CPU está instalada. Como reinstalar a versão correta do CUDA para ComfyUI portátil, manual e setups AMD/Mac.

Serviços na nuvem
Como rodar modelos de IA na nuvem (guia para iniciantes 2026): Flux, Wan e SDXL sem GPU
Sem GPU, ou sem VRAM suficiente? Três jeitos de rodar Stable Diffusion, Flux, Wan 2.2 e outros modelos de IA para imagem e vídeo na nuvem: um serviço hospedado que você usa pelo celular, uma GPU alugada por hora para ComfyUI, ou demos grátis com limites. Quanto custa cada um em 2026, como começar e qual escolher.

Aplicativos
Ollama vs LM Studio (2026): qual app de IA local usar e quais os melhores modelos que cada um roda
Ollama e LM Studio são as duas formas gratuitas de rodar uma IA estilo ChatGPT no seu próprio computador, e ambos rodam os mesmos modelos abertos. Ollama é open source, leve e feito para ser o motor por trás de outros apps; LM Studio é um app de desktop polido com navegador de modelos e o motor mais rápido em Macs com Apple silicon. Essa comparação cobre velocidade, suporte a Mac, NVIDIA e AMD, servidor local, agentes de código e privacidade, e quais dos modelos abertos mais bem ranqueados desta semana cada um roda no seu hardware.

Modelos
Melhor LLM local por caso de uso (outubro de 2026): o modelo aberto certo para cada tarefa
Não existe um único melhor LLM local: o modelo aberto certo depende da tarefa e da sua memória. Usando o ranking de modelos de texto desta semana, este guia escolhe um modelo para cada caso de uso (bate-papo diário, programação, agentes de programação, raciocínio, leitura de imagens, documentos longos, tradução, escrita criativa, laptops, busca em seus próprios arquivos e voz), com a memória que cada um precisa, uma alternativa e os comandos para rodá-los. Também explica por que os modelos abertos ranqueados em #1 precisam de servidor e quais dos seus irmãos menores cabem em casa.

Aplicativos
Como Instalar Ollama e Rodar uma IA Local (Windows, Mac, Linux)
Você pode rodar uma IA estilo ChatGPT no seu próprio PC ou Mac de graça, offline e sem taxas por token. Este guia mostra como instalar o Ollama, qual modelo baixar para 8, 16, 24 ou 32 GB de memória, como conversar com ele e o que fazer quando estiver lento ou sem memória.
ComfyUI
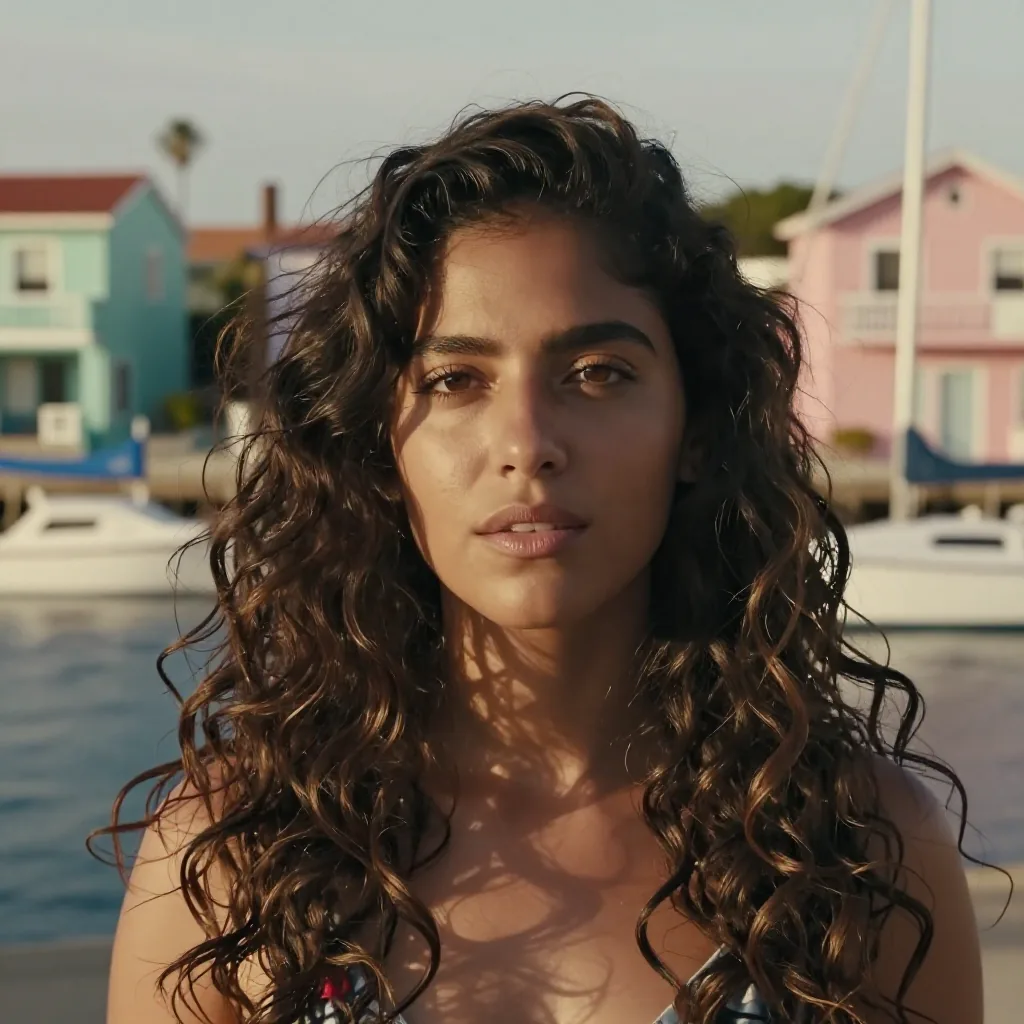
Fluxo de trabalho Z-Image Turbo ComfyUI: retratos fotorrealistas em 8 passos
O template Z-Image Turbo da equipe ComfyUI: o modelo de fluxo único 6B, o codificador de texto Qwen3 4B e o Flux VAE em doze nós, 8 passos com cfg 1 usando res_multistep. Três arquivos, prompts em inglês e chinês, e as configurações para placas de 8 GB e 16 GB. JSON do fluxo de trabalho hospedado aqui.
ComfyUI
FLUX.2 [klein] 4B texto para imagem ComfyUI workflow: imagens em menos de um segundo em uma placa de 8 GB
O template FLUX.2 klein 4B texto para imagem da equipe ComfyUI: dois subgrafos lado a lado (o 4B destilado em cfg 1, o 4B base em cfg 5), o codificador de texto Qwen3 4B e o VAE FLUX.2. Três a quatro arquivos, 1024x1024 por padrão, e o modelo de imagem rápido e bom que você pode rodar localmente. Workflow JSON hospedado aqui.

ComfyUI
Fluxo de trabalho Wan 2.2 5B ComfyUI: texto ou imagem 720p para vídeo em uma placa intermediária
O fluxo de trabalho Wan 2.2 5B TI2V da equipe ComfyUI: um modelo faz texto para vídeo e imagem para vídeo em 1280x704, 24 fps, 121 quadros. Três arquivos, treze nós, sem LoRA. O melhor fluxo de vídeo em qualidade por gigabyte para placas de 12 a 16 GB. JSON do fluxo de trabalho hospedado aqui.
ComfyUI
Fluxo de trabalho Qwen Image Edit 2509 ComfyUI: edite fotos com uma frase e até três imagens de referência
O template Qwen Image Edit 2509 da equipe ComfyUI: o modelo fp8, o codificador de texto Qwen2.5-VL, o LoRA Lightning de 4 passos e o nó TextEncodeQwenImageEditPlus que aceita até três imagens. Quatro arquivos, 4 passos com cfg 1, e os prompts que funcionam para substituir, adicionar e restilizar. JSON do fluxo de trabalho hospedado aqui.

ComfyUI
Wan 2.1 texto para vídeo (1.3B) fluxo ComfyUI: seu primeiro vídeo local em uma placa de 8 GB
O fluxo de trabalho Wan 2.1 1.3B texto para vídeo com dez nós da equipe ComfyUI: quatro arquivos para baixar, 832x480 a 33 quadros, 30 passos com uni_pc. Roda com 8 GB de VRAM, a forma mais fácil de fazer um primeiro vídeo localmente. JSON do fluxo hospedado aqui.
ComfyUI
Fluxo de trabalho Wan 2.2 14B de imagem para vídeo no ComfyUI: o melhor gráfico aberto foto-para-clip
O template Wan 2.2 14B de imagem para vídeo da equipe ComfyUI: modelos de alto e baixo ruído, os LoRAs lightx2v de 4 passos, 640x640 com 81 frames. Quais seis arquivos baixar, como pedir movimento para uma imagem parada e os interruptores dentro do subgrafo. JSON do fluxo de trabalho hospedado aqui.
ComfyUI
Wan 2.2 14B texto para vídeo ComfyUI workflow: dois modelos, um LoRA de 4 passos, movimento com qualidade de cinema
Explicação do template Wan 2.2 14B texto para vídeo da equipe ComfyUI: por que tem um modelo de alto ruído e outro de baixo ruído, o que o LoRA lightx2v de 4 passos faz, os seis arquivos e onde colocá-los, e as configurações que transformam nove minutos em dois numa placa de 24 GB. Workflow JSON hospedado aqui.
ComfyUI
FLUX.2 [klein] fluxo de trabalho ComfyUI para edição de imagem 4B: edição com uma ou múltiplas referências em segundos
O template de edição destilada FLUX.2 klein 4B da equipe ComfyUI: dois subgrafos, um para uma imagem de referência única e outro que combina duas, construído com nós ReferenceLatent. Três arquivos, cfg 1, quatro passos e os padrões de prompt para recoloração, mudança de estilo e empréstimo de uma segunda imagem. JSON do fluxo de trabalho hospedado aqui.
ComfyUI
Fluxo de trabalho LTX-2 texto para vídeo ComfyUI: imagem e som a partir de um único prompt
O template de texto para vídeo LTX-2 da equipe ComfyUI: o checkpoint 19B fp8, o codificador de texto Gemma 3, uma renderização em duas etapas com o upscaler latente 2x e o LoRA destilado, e áudio sincronizado. Cinco arquivos, as regras 64 pixels e 8n+1, e como criar prompts para diálogos. JSON do fluxo de trabalho hospedado aqui.
ComfyUI
Fluxo de trabalho ComfyUI LTX-2 de imagem para vídeo: anime uma imagem fixa com som sincronizado
O template de imagem para vídeo LTX-2 da equipe ComfyUI: carregue a imagem no LTXVImgToVideoInplace, o checkpoint 19B fp8 e o codificador Gemma 3, o upscale em duas etapas com o LoRA destilado, áudio gerado com o clip. Cinco arquivos, regras de tamanho e prompts para movimento e som. JSON do fluxo de trabalho hospedado aqui.
ComfyUI
Wan 2.1 imagem para vídeo (480p, 14B) fluxo ComfyUI: animar uma foto
O fluxo de trabalho Wan 2.1 480p imagem-para-vídeo da equipe ComfyUI: Carregar Imagem, CLIP Vision e o nó WanImageToVideo em torno do modelo 14B, 20 passos com uni_pc. Quais são os cinco arquivos, onde colocá-los e como criar o prompt para o movimento. Fluxo JSON hospedado aqui.
ComfyUI
FLUX.1 Kontext [dev] ComfyUI workflow: edição consistente de imagem com duas imagens de referência
O template FLUX.1 Kontext dev da equipe ComfyUI: o modelo fp8 Kontext, clip_l mais T5, o Flux VAE, Image Stitch para duas referências e o nó ReferenceLatent. Quatro arquivos, 20 passos, orientação 2.5 e as técnicas de prompt das notas do template. JSON do workflow hospedado aqui.
ComfyUI
Fluxo de trabalho Wan 2.2 Animate ComfyUI: substituição de personagem e transferência de pose a partir de um vídeo
O template Wan 2.2 Animate da equipe ComfyUI: anima uma imagem de personagem com o movimento de um vídeo de referência (modo Move) ou substitui a pessoa no vídeo (modo Mix). Os três pacotes de nós personalizados necessários, o editor de pontos SAM2, o LoRA de relighting e o LoRA de 4 passos, e como estender além de 77 quadros. JSON do fluxo de trabalho hospedado aqui.

ComfyUI
Fluxo de trabalho ComfyUI HunyuanVideo texto para vídeo: o modelo 13B que iniciou o vídeo local
O fluxo de trabalho de exemplo ComfyUI para o HunyuanVideo da Tencent: o modelo 13B 720p com clip_l e o codificador LLaVA-Llama 3, uma cadeia SamplerCustomAdvanced com FluxGuidance 6 e shift 7, decodificação VAE em blocos, 848x480 a 73 quadros. Quatro arquivos, o interruptor fp8 para placas de 8 a 16 GB, e os prompts que ele prefere. JSON do fluxo de trabalho hospedado aqui.

Aplicativos
AMD Amuse em 2026: o que aconteceu e você ainda deve usar?
Amuse, o app fácil de IA para imagens da AMD, foi descontinuado pelo desenvolvedor e lançado como código aberto. O que a versão da comunidade faz agora (v3.8.2 com instalador pronto para Windows), quem mantém, e as opções melhores para GPUs AMD.

Serviços na nuvem
Taxa fixa vs tokens: por que planos ilimitados como o Graydient.ai são o melhor custo-benefício para criadores de IA em 2026
Uma comparação de custos ranqueada, com preços verificados em 8 de outubro de 2026, entre planos ilimitados com taxa fixa como o Graydient.ai e preços por token e crédito do Midjourney, Leonardo, fal.ai, Replicate, Runway e Kling: quanto realmente custam 1.000 imagens e 1.000 vídeos por mês em cada um, e por que uma taxa fixa para imagens, vídeos, áudio, chat Grok LLM e apps web ilimitados é o melhor custo-benefício para criadores que fazem várias versões.
Aplicativos
Como instalar Wan2GP: vídeos e imagens de IA em GPUs com pouca VRAM
Wan2GP roda Wan, LTX, Hunyuan, Flux e Qwen em GPUs com apenas 6 GB de VRAM. Como instalar no Windows, Linux ou em uma placa AMD (Pinokio, scripts incluídos ou manualmente), quais configurações usar e o que fazer quando acabar a memória.