Modèles IA Stable Diffusion 1.5
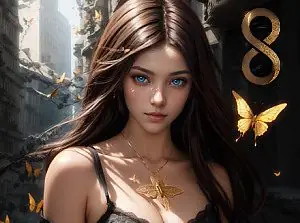
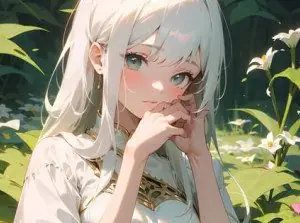
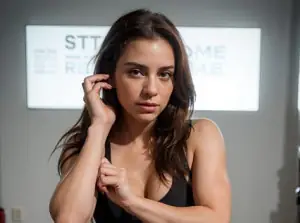
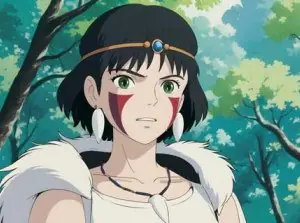
Stable Diffusion 1.5 is the 2022 model that started the open-source image movement. It is a 512 pixel latent diffusion model that runs on almost any GPU, trains LoRAs in minutes and still has the largest library of textual-inversion embeddings. Realistic Vision, DreamShaper, Deliberate, ReV Animated and Anything are among the checkpoints that defined a generation of AI art. Newer families surpass it in prompt following and resolution, but SD 1.5 remains the fastest way to learn, the best fit for weak hardware and the only home of many classic styles.
Modèles Stable Diffusion 1.5 les plus populaires


Guides Stable Diffusion 1.5

Modèles
Stable Diffusion 1.5 : le modèle classique, bien utilisé
Stable Diffusion 1.5 vaut toujours le coup : la bonne résolution, CFG et sampler, comment utiliser sa grande bibliothèque de LoRAs et embeddings, et des idées de prompts créatifs adaptés à un modèle 512 pixels.

Par Captain
2026-10-02

Modèles
Waifu Diffusion : Utiliser les tags Danbooru pour un modèle d’anime classique
Waifu Diffusion est le modèle de base anime qui a appris à toute une génération à utiliser les tags Danbooru pour les prompts. Ce guide explique l’ordre des tags, les tags de qualité, les négatifs, la bonne résolution et des idées pour des illustrations anime propres.
Par Captain
2026-10-01

Erreurs et solutions
Erreurs ComfyUI et comment les réparer : nœuds rouges, modèles manquants, mémoire CUDA insuffisante
Les messages d'erreur ComfyUI que les gens rencontrent en premier, ce que chacun signifie et la solution qui marche : nœuds personnalisés manquants (boîtes rouges), « Prompt outputs failed validation », mémoire CUDA insuffisante, mauvais type de modèle dans un chargeur, erreurs de forme mat1 et mat2, désérialisation d'en-tête, incompatibilités torch et xformers.
Par Captain
2026-05-12

Modèles
Qu'est-ce qu'un LoRA et comment l'utiliser dans ComfyUI, Forge, Automatic1111 et sur le cloud
Explication des LoRAs pour ceux qui veulent des résultats, pas des maths : ce qu'un fichier LoRA change, pourquoi il doit correspondre à la famille du modèle de base, les mots déclencheurs, les poids, empiler plusieurs LoRAs, le dossier et la syntaxe pour chaque interface, et comment tester un LoRA sur le cloud avant de télécharger quoi que ce soit.
Par Captain
2026-05-20

Erreurs et solutions
CUDA mémoire insuffisante : combien de VRAM chaque modèle IA nécessite et comment l’adapter
Un tableau de VRAM pour SD 1.5, SDXL, Flux, FLUX.2, Qwen-Image, Z-Image, Wan 2.2 et HunyuanVideo, et les techniques pour faire tenir un modèle : quantification fp8 et GGUF, déchargement CPU, VAE en tuiles, limites de résolution et de frames, et quand arrêter de lutter et passer à l’hébergement.
Par Captain
2026-05-18

Modèles
Flux vs SDXL vs SD 1.5 vs Qwen vs Z-Image : quelle famille de modèles utiliser en 2026
Une comparaison pratique des familles de modèles d’image open source : suivi des prompts, réalisme, anime et illustration, rendu du texte, vitesse, VRAM, écosystème LoRA et licence, avec une recommandation pour chaque type de travail et matériel.
Par Captain
2026-05-22
AD
Aucune installation requise – exécutez les modèles IA dans le cloud
Pas de GPU, pas de téléchargement, pas de Python. Ces services exécutent les mêmes modèles open source sur leurs propres serveurs : vous générez depuis un navigateur, Discord ou Telegram en une minute.


Autres familles de modèles
Modèles Text / LLM
411
Modèles Anima
366
Modèles Chroma
12
Modèles Flux
828
Modèles Flux 2 / Klein
710
Modèles MiniMax H3
152
Modèles Hunyuan
104
Modèles Ideogram
7
Modèles Krea2
377
Modèles Qwen
13
Modèles Qwen2
26
Modèles Ltx2
79
Modèles Stable Diffusion XL 1.0
8,549
Modèles Zimage
348
Modèles Wan
342
Modèles ACE-Step
2
Modèles AuK
1
Modèles Boogu
2
Modèles Chatterbox TTS
1
Modèles Cosmos
1
Modèles Ernie Image
2
Modèles FireRed
1
Modèles HeartMuLa
1
Modèles HiDream
3
Modèles Higgs Audio
1
Modèles Lumina
2
Modèles MiniMax Music
1
Modèles MisoTTS
1
Modèles Microsoft Lens
1
Modèles PixelDiT
1
Modèles Stable Diffusion 3.5
3
Modèles Upscalers
11
Modèles YuE
2

Model
Trends
.ai
© ModelTrends.ai
|
Fabriqué au Japon
|
© 2026